
Pubblicato il - Aggiornato il
Contenuti duplicati: cosa sono e come risolverli lato SEO
SEO
illustration by Fabio Massimo De Luca
I contenuti duplicati possono diventare un problema per l’evoluzione di un sito web. Non solo quando esistono pagine identiche, ma anche quando più URL mostrano contenuti molto simili o soddisfano la stessa intenzione di ricerca.
Molti pensano che Google penalizzi automaticamente queste situazioni. In realtà non esiste una vera e propria “penalizzazione per contenuti duplicati” nel significato che normalmente viene attribuito a questa espressione.
“There’s no such thing as a duplicate content penalty. At least, not in the way most people mean when they say that.”
Come spiegato da Google nel suo articolo Demystifying the duplicate content penalty, il problema non è tanto la presenza di contenuti simili, quanto aiutare il motore di ricerca a capire quale versione mostrare agli utenti e quale URL considerare principale.
Questo però non significa che la questione possa essere ignorata. Più pagine simili possono competere tra loro, disperdere segnali SEO e rendere più difficile per Google capire quale contenuto mostrare nei risultati di ricerca.
Inoltre i contenuti duplicati non nascono solo dal classico copia e incolla. Possono essere causati da categorie e tag troppo simili, parametri URL, filtri degli e-commerce, versioni multiple della stessa pagina o scelte editoriali poco efficaci.
Come ricorda la stessa Google nelle linee guida dedicate ai contenuti utili, l’obiettivo dovrebbe essere creare pagine con uno scopo chiaro e un valore distintivo per gli utenti, evitando di pubblicare più contenuti che rispondono alla stessa esigenza senza aggiungere nuove informazioni.
Quello che possiamo fare è ridurre il più possibile queste sovrapposizioni e aiutare Google a comprendere quale contenuto merita di essere indicizzato e posizionato.
Indice dei contenuti
Cosa sono i contenuti duplicati su un sito web
I contenuti duplicati sono pagine web che presentano contenuti identici o molto simili e che possono rendere difficile per Google capire quale URL indicizzare e mostrare nei risultati di ricerca.
Con questo termine intendiamo soprattutto pagine dello stesso sito che, dal punto di vista dell’utente e del motore di ricerca, soddisfano la stessa intenzione di ricerca.
Se non del tutto uguali. A volte queste pagine vengono create a causa di errori tecnici, come archivi che si replicano all’infinito, URL generate da parametri o problemi di configurazione della navigazione. In altri casi è la stessa struttura del progetto a produrre contenuti molto simili, ad esempio le varianti di un prodotto in un e-commerce.
Se vendi una maglietta disponibile in diversi colori o taglie, potresti ritrovarti con più URL che mostrano informazioni quasi identiche. Anche se ogni pagina ha una sua ragione di esistere, per Google la differenza potrebbe non essere sufficiente.
Un’altra causa frequente dei contenuti duplicati sono le scelte editoriali. Succede quando nel tempo vengono pubblicati più articoli che soddisfano la stessa intenzione di ricerca, anche se utilizzano keyword o titoli differenti.
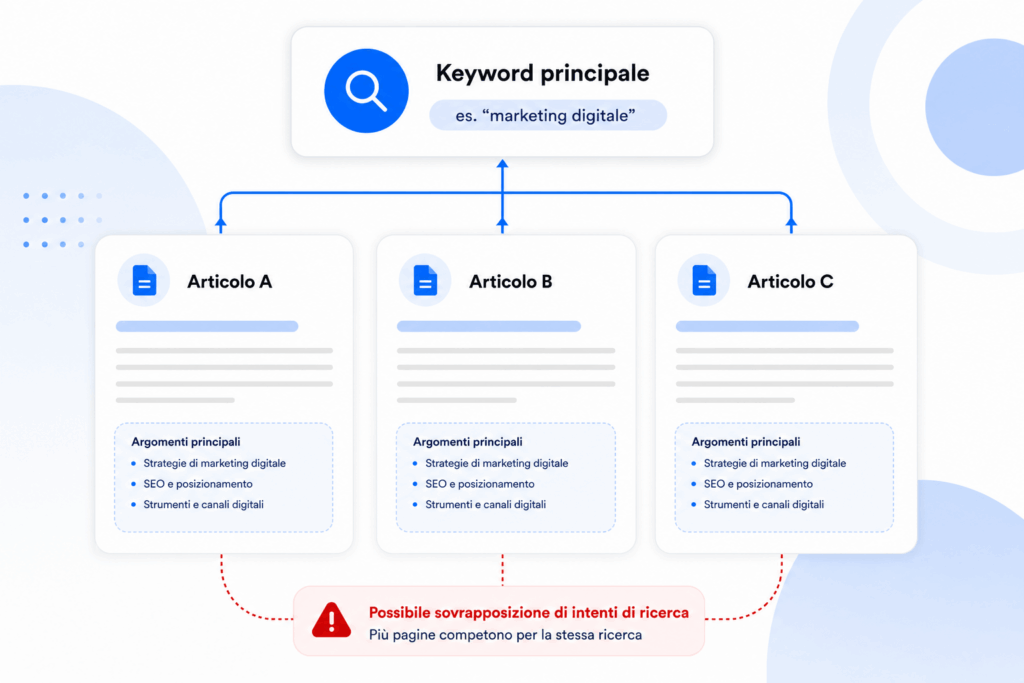
Immagina di avere un articolo intitolato “Come fare SEO per e-commerce” e, qualche mese dopo, pubblicarne un altro chiamato “SEO per negozi online: guida completa”. Se gran parte delle informazioni coincide, le due pagine potrebbero finire per competere tra loro nei risultati di ricerca.
Anche quando i testi non sono identici parola per parola, i motori di ricerca sono in grado di riconoscere un’elevata somiglianza tra i contenuti. Per questo motivo modificare qualche frase o cambiare alcuni paragrafi non è sempre sufficiente per creare una pagina realmente diversa.
Lo stesso problema può verificarsi quando una notizia viene ripubblicata su più siti o quando contenuti provenienti da comunicati stampa vengono copiati e distribuiti senza modifiche sostanziali.
Tutto questo non rappresenta necessariamente una penalizzazione, ma può creare confusione per i motori di ricerca e ridurre l’efficacia complessiva della strategia SEO.
Come Google riconosce contenuti duplicati o molto simili
Quando si parla di contenuti duplicati si pensa spesso a pagine perfettamente identiche. In realtà i motori di ricerca devono riconoscere anche documenti che differiscono per poche frasi, per l’ordine di alcuni paragrafi o per dettagli di formattazione.
Per questo motivo Google non confronta semplicemente due pagine parola per parola, ma valuta quanto i loro contenuti siano simili nel complesso.
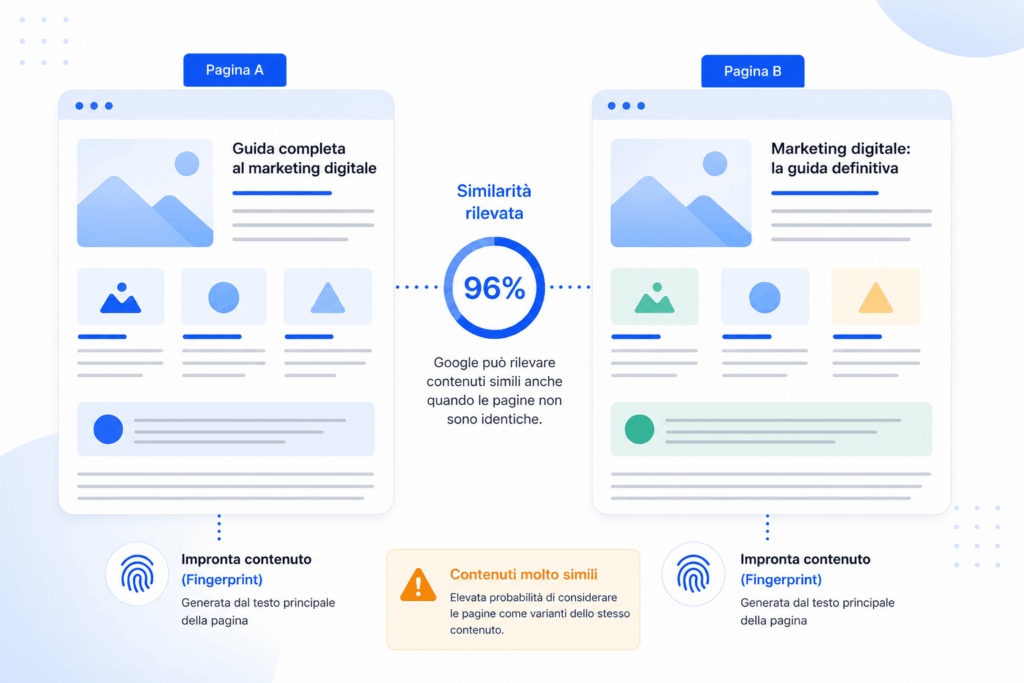
Per farlo utilizza tecniche di content fingerprinting. Una delle più note è SimHash, un algoritmo di locality-sensitive hashing sviluppato da Moses Charikar e reso popolare dai sistemi di deduplicazione utilizzati su larga scala dai motori di ricerca.
Il principio è semplice: ogni pagina viene trasformata in una sorta di impronta digitale numerica. Due documenti molto simili produrranno impronte molto vicine tra loro anche se non sono identici parola per parola.
Questo consente di individuare rapidamente:
- URL differenti che mostrano lo stesso contenuto principale;
- problemi di canonicalizzazione;
- parametri URL che generano copie della stessa pagina;
- navigazioni faccettate non gestite correttamente;
- articoli quasi duplicati pubblicati nel tempo;
- contenuti sindacati o ripubblicati su più siti.
In altre parole, cambiare qualche frase o sostituire alcuni termini non è sufficiente per creare un contenuto realmente diverso. Se struttura, significato e informazioni restano sostanzialmente gli stessi, i sistemi di deduplicazione possono comunque considerarlo una variante dello stesso documento.
È uno dei motivi per cui più articoli che rispondono alla stessa intenzione di ricerca possono finire per sovrapporsi e competere tra loro nei risultati di Google.
Come evitare i contenuti duplicati sui siti web
In primo luogo bisogna seguire una regola ben definita: punta sulla semplicità. Questo significa che le strutture complesse e le architetture improvvisate rischiano di creare contenuti duplicati. La base è chiara: ogni pagina deve avere uno scopo unico, non sovrapponibile con un’altra. Allora, ad esempio, di landing page che affrontano:
- Formazione per proprietari di azienda
- Corsi formativi per CEO aziendali
Potrebbero essere in conflitto. Lo stesso ragionamento si può fare per le categorie del blog,
ecco qualche esempio ben chiaro legato anche a un altro problema storico: i tag.
- Categoria: Web Marketing
- Tag: Web Marketing Online
- Articolo: Web marketing, cos’è e come si fa
Abbiamo tre pagine che soddisfano lo stesso search intent. Ovvero quello del web marketing. Cosa vedrà il pubblico? Contenuto inutile, non navigabile.
Cosa deve pensare Google? Il risultato sarà un risparmio di crawl budget, dato che c’è
qualcosa di superfluo, e quindi qualcosa rimarrà fuori dal posizionamento virtuoso.
Un buon modo per evitare i contenuti duplicati è quello di valutare prima di scrivere. In che modo? In primo luogo puoi chiedere a SEOZoom di individuare se un determinato tema può essere considerato un main topic o se conviene puntare verso un tema più inclusivo.
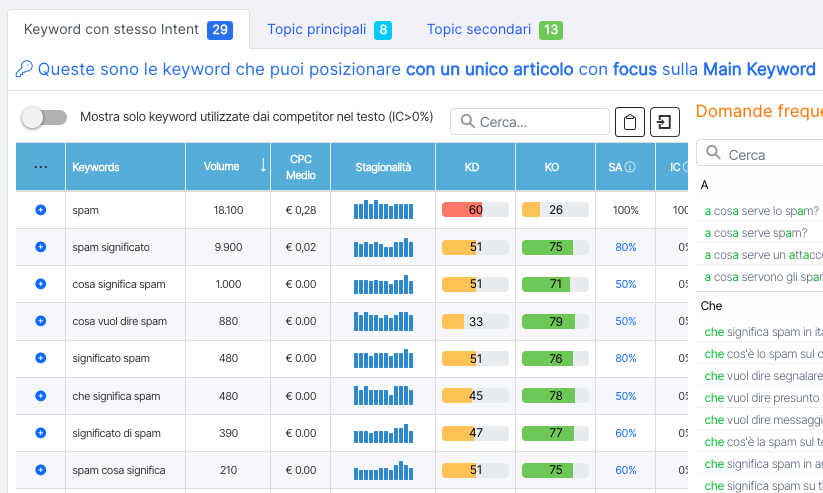
Ad esempio, inutile avere un articolo che mi spiega cos’è lo spam e un altro che approfondisce l’origine del nome, ne creo uno solo e punto a entrambe le query.
Inoltre, prima di creare una qualsiasi pagina (post, landing, tag, categoria) fai un “site: [dominio] + [keyword]” su Google in modo da verificare se e come hai trattato l’argomento. Ricorda, prima di creare un blog post su un tema valuta se è il caso di aggiornare quello che è già online. Così eviti duplicati.
Un problema simile si verifica negli e-commerce
Quando una categoria prodotto genera URL diverse attraverso filtri, ordinamenti o parametri di ricerca, possono nascere molte pagine quasi identiche tra loro.
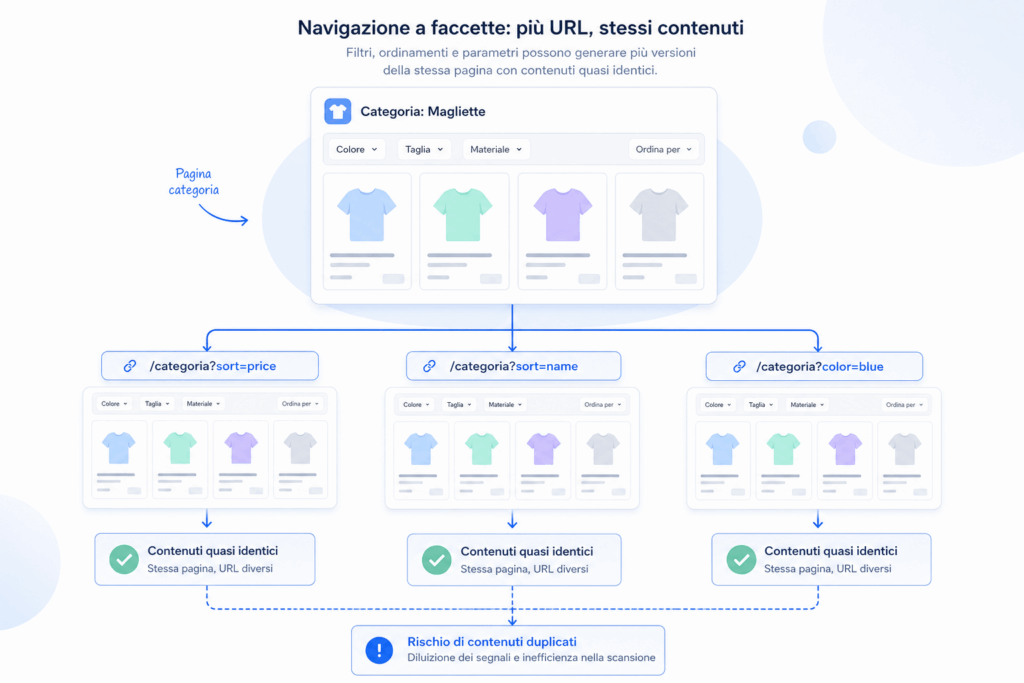
Ad esempio, una categoria potrebbe essere accessibile tramite:
/categoria?sort=price/categoria?sort=name/categoria?color=blue
Dal punto di vista dell’utente il contenuto cambia poco, mentre per Google si tratta di URL differenti che richiedono una gestione SEO attenta.
Se lasciate indicizzabili senza controllo, queste pagine possono disperdere segnali di ranking, aumentare il numero di URL da scansionare e generare contenuti molto simili tra loro.
Come trovare i contenuti duplicati
I contenuti duplicati non sono sempre evidenti. In molti casi il problema nasce nel tempo a causa di nuove pubblicazioni, modifiche alla struttura del sito o URL generate automaticamente dal CMS.
Per individuare eventuali duplicazioni puoi partire da alcuni controlli pratici.
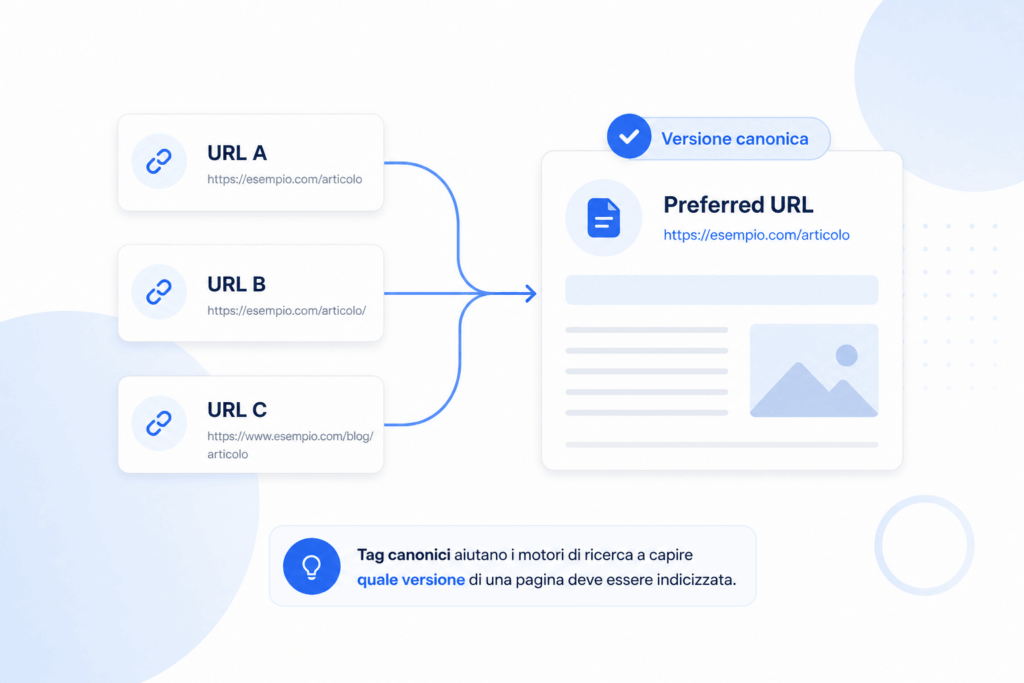
1. Cerca URL diverse che mostrano lo stesso contenuto
Uno dei casi più comuni è la presenza di più URL che restituiscono una pagina quasi identica. Può succedere con versioni HTTP e HTTPS, URL con o senza slash finale, parametri di tracciamento o varianti generate da filtri e ordinamenti.
In questi casi è importante verificare che sia presente una versione canonica correttamente dichiarata.
2. Analizza il sito con un crawler SEO
Strumenti come Screaming Frog, Sitebulb o Seobility possono individuare pagine con titolo, meta description o contenuti molto simili.
Durante la scansione presta particolare attenzione a:
- URL con contenuti quasi identici;
- categorie e tag che generano pagine sovrapposte;
- parametri URL indicizzabili;
- archivi e pagine filtro.
3. Controlla Google Search Console
La sezione “Indicizzazione > Pagine” di Search Console può evidenziare segnali utili come:
- Pagina alternativa con tag canonico appropriato;
- Pagina duplicata senza URL canonica selezionata dall’utente;
- Google ha scelto una pagina canonica diversa da quella indicata.
Questi report aiutano a capire quando Google rileva più versioni dello stesso contenuto.
4. Cerca sovrapposizioni tra gli articoli
Non tutti i contenuti duplicati sono problemi tecnici. A volte due articoli rispondono alla stessa intenzione di ricerca pur avendo titoli differenti.
Se più pagine del sito cercano di posizionarsi per le stesse query, potrebbe esserci una sovrapposizione editoriale da analizzare.
5. Utilizza strumenti di analisi della similarità
I software SEO più avanzati utilizzano tecniche di content fingerprinting per confrontare il contenuto principale delle pagine e individuare documenti molto simili tra loro.
Anche nei tool che ho sviluppato per analizzare siti web utilizzo questo approccio: viene estratto il contenuto principale delle pagine, eliminando elementi come menu e footer, e successivamente vengono confrontate le impronte digitali generate dal testo.
In questo modo è possibile individuare rapidamente:
- URL diverse che mostrano lo stesso contenuto;
- problemi di canonicalizzazione;
- parametri URL che generano copie della stessa pagina;
- navigazioni faccettate non gestite correttamente;
- articoli quasi duplicati pubblicati nel tempo.
Il vantaggio di questo approccio è che non richiede contenuti identici parola per parola. Anche pagine con piccole differenze possono essere segnalate quando il livello di similarità supera una determinata soglia.
Modalità per risolvere i contenuti duplicati SEO
Hai trovato dei contenuti duplicati? Bene, adesso evita la tentazione di intervenire subito.
Prima di eliminare una pagina, creare un redirect o impostare un tag canonical devi capire perché quelle URL sono così simili. Potrebbe trattarsi di un problema tecnico, di una scelta editoriale poco efficace o semplicemente di pagine che rispondono alla stessa intenzione di ricerca.
La regola è una sola: analizzare il contesto. L’obiettivo non è cancellare contenuti, ma aiutare Google a capire quali pagine meritano davvero di essere indicizzate e posizionate.
Modifica del contenuto
Il primo metodo per affrontare i contenuti duplicati: lavorare su una riscrittura e, se necessario, sul cambio URL con relativo redirect 301 per cambiare direzione e aiutare i motori di ricerca a capire che c’è stato un errore. E che le due pagine trattano temi differenti.
Poi, in alcuni casi si può puntare sulla fusione tra due pagine: si individua quella che ha meno risorse, si copiano eventuali contenuti utili e si copiano sulla pagina vincente. Poi si cancella e si fa un bel redirect 301 sulla pagina che decidiamo di mantenere.
Cancellare pagine inutili
In alcuni casi, il modo migliore per risolvere il problema dei contenuti duplicati è quello di cancellare pagine superflue. Qualche esempio? Hai due o più tag semanticamente uguali ma non omonimi (esempio: copy writer, copywriter) oppure archivi completamente simili.
Quest’ultima ipotesi avviene quando la pagina autore si sovrappone all’archivio principale (tipica situazione da blog monoautore). Ancora una condizione: hai decine di articoli che parlano dello stesso tema a distanza di poco tempo, come ad esempio avviene per i magazine quando si anticipa un’allerta meteo.
Cosa fare in questi casi? Verificata assenza di traffico, di ranking e di backlink si cancella quello che non serve. Diciamolo, possiamo tranquillamente lavorare in questa direzione anche per le pagine media e gli archivi per data a meno che non ci siano esigenze.
Dare indicazioni a Google
In alcuni casi il problema non è lato UX ma SEO. Infatti, molte sono le circostanze in cui le pagine non devono essere né modificate, né cancellate. Come fare in questi casi?
- Canonical: indica su una pagina web qual è la versione che Google deve prendere in considerazione. Se, ad esempio, ho due pagine simili e voglio che Google ne consideri solo una per l’indicizzazione metto l’URL di quest’ultima nel canonical della risorsa da mettere da parte così Google non la considera duplicata. Un po’ come dire a Google: “Ok, non è un contenuto di valore ma ne abbiamo bisogno”.
- Noindex: il riferimento valido per qualsiasi situazione in cui non vuoi che Google indicizzi la risorsa, a prescindere dal fatto che ci sia o meno una pagina correlata. Se, ad esempio, hai dei contenuti presenti su altri siti web e hai il permesso di distribuirli, puoi utilizzare il meta tag noindex per pubblicarli senza ripercussioni.
In determinate situazioni puoi agire con la mannaia e utilizzare il robots.txt per chiudere determinate sezioni o directory allo sguardo di Google. Nonostante tutto, queste sono sempre indicazioni che diamo al motore di ricerca e non vincoli assoluti.
L’unico modo per evitare al 100% che Google veda un contenuto duplicato, che non vuoi cancellare, è una sezione protetta da password. Che può essere un’idea per archivi di news o documenti presenti altrove e che vuoi far scaricare solo a determinate persone.
Cosa fare prima di procedere?
Non esiste una soluzione valida per tutti i casi. Prima di eliminare una pagina, impostare un redirect o aggiungere un tag canonical è fondamentale capire quale ruolo svolge quel contenuto all’interno del sito.
In alcuni casi il problema nasce da errori tecnici, come URL multiple che mostrano lo stesso contenuto. In altri dipende dalla struttura editoriale, da articoli che si sovrappongono o da categorie e tag che finiscono per soddisfare la stessa intenzione di ricerca.
Per questo motivo è sempre consigliabile partire da un’analisi SEO approfondita. L’obiettivo non è eliminare il maggior numero possibile di pagine, ma capire quali contenuti mantenere, consolidare o differenziare per aiutare Google a comprendere meglio la struttura del sito.
Una valutazione errata può portare alla perdita di traffico organico, mentre un intervento ben pianificato può migliorare indicizzazione, scansione e visibilità nei risultati di ricerca.
Se hai dubbi sulla presenza di contenuti duplicati o vuoi capire come ottimizzare l’architettura del tuo sito, una consulenza SEO può aiutarti a individuare le criticità e definire la strategia più adatta al tuo progetto.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.