
Pubblicato il
Crawl budget: cos’è, come funziona e come ottimizzarlo per la SEO
SEO
Il crawl budget è il tempo che Google decide di spendere sul tuo sito. Non è poesia, è logistica e efficienza: un bot che entra, scorre URL, prende appunti e poi se ne va. Se il sito è piccolo, spesso non te ne accorgi nemmeno. Se cresce, o se ha molte pagine simili tra loro, quel tempo diventa una risorsa da amministrare con metodo.
Indice dei contenuti
Perché il crawl budget incide su indicizzazione e ranking
Quando si parla di visibilità organica, viene naturale fissarsi su contenuti e link. Il crawl budget sta un passo prima: decide quali pagine Google scopre, con che frequenza torna a rileggerle e quanta energia spreca su URL che non portano valore. Non è un interruttore che accende o spegne il ranking, ma può rallentare l’indicizzazione, lasciare pagine importanti fuori dall’indice e far perdere reattività agli aggiornamenti.
Differenza tra scansione (crawl) e indicizzazione (index)
La scansione è l’atto di visita: Googlebot richiede una pagina, ne legge il codice, segue alcuni link e raccoglie segnali. È come sfogliare un libro in libreria per capire di cosa parla. L’indicizzazione, invece, è la decisione di inserirla nel catalogo, renderla recuperabile in ricerca e collegarla alle query potenzialmente rilevanti.
Questi due momenti non coincidono sempre. Una pagina può essere scansionata molte volte e restare fuori dall’indice, magari perché duplicata, povera di contenuto o troppo simile a un’altra URL che Google considera migliore. Al contrario, una pagina già indicizzata può essere scansionata raramente se non cambia mai e non riceve segnali di importanza.
Capire la differenza evita un classico cortocircuito: vedere traffico del bot nei log e pensare che tutto vada bene. In realtà, il bot può stare consumando tempo su URL marginali mentre quelle che ti interessano restano in coda. Il crawl budget entra qui: condiziona la velocità con cui Google arriva dove vuoi tu.
Perché Google non scansiona tutto subito: priorità, risorse e gestione del crawl budget
Google non regala scansioni illimitate. Anche se la sua infrastruttura è enorme, deve distribuire risorse su miliardi di pagine. Ogni sito riceve una certa attenzione, calibrata su segnali che dicono quanto valga la pena tornare e quanto sia sicuro farlo senza sovraccaricare il server.
Qui entrano in gioco due idee semplici. La prima: Google dà precedenza a ciò che sembra utile e richiesto, quindi pagine popolari, aggiornate, ben collegate. La seconda: Google evita di martellare siti lenti o instabili, perché ogni richiesta costa tempo e rischia di peggiorare l’esperienza di chi sta navigando davvero.
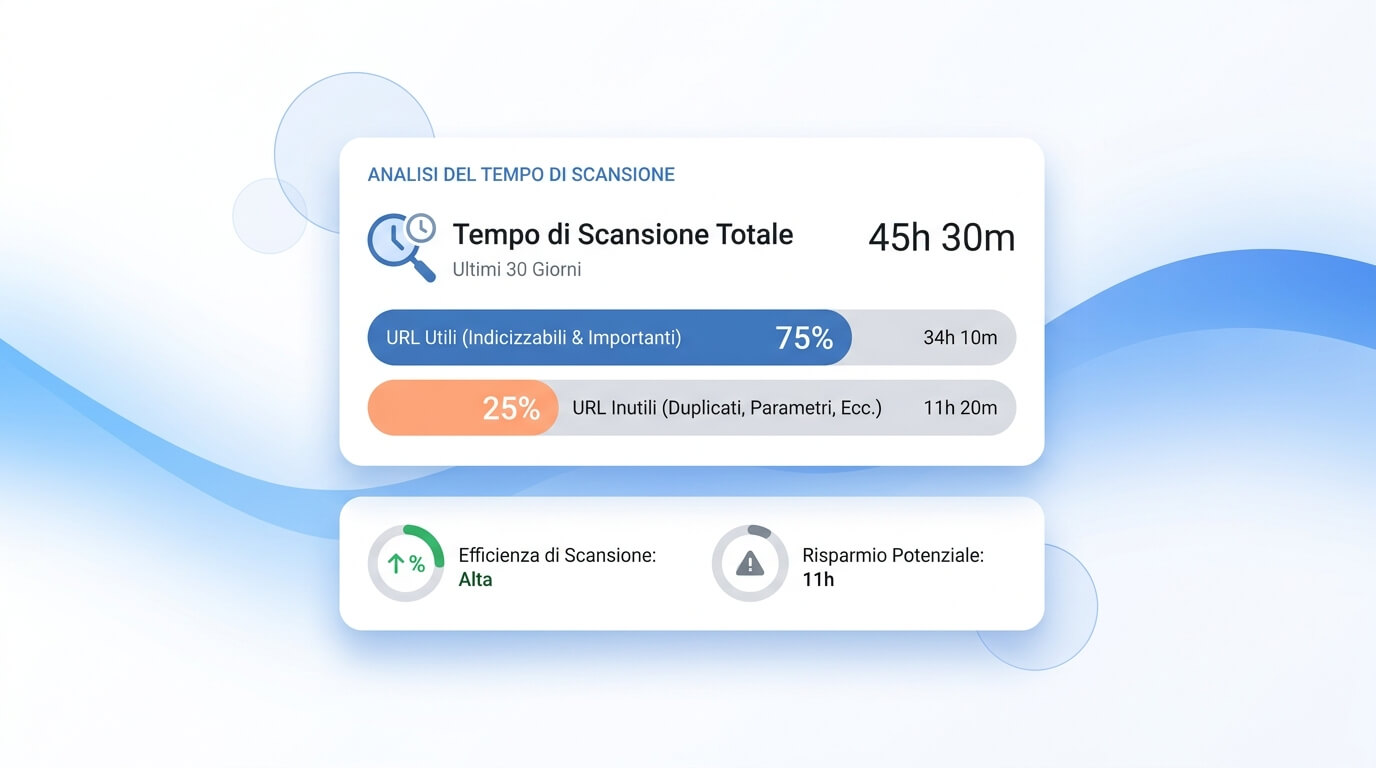
In mezzo c’è la gestione pratica: Googlebot sceglie un percorso, prova URL, ne scarta alcune, torna indietro, ripete. Se trova troppe pagine simili, redirect a catena, errori e parametri infiniti, la scansione si trasforma in una passeggiata a vuoto. E quella passeggiata, alla fine, la paghi tu in termini di indicizzazione e freschezza.
Quali siti sono più esposti al crawl budget (e-commerce, portali, marketplace)
Non tutti i siti vivono lo stesso rischio. Un blog con poche decine di articoli ben distinti raramente soffre di crawl budget, perché Google riesce a leggere tutto senza sforzo. Il problema cresce quando aumentano le URL e, soprattutto, quando aumentano le URL che si assomigliano.
Gli e-commerce sono i candidati più comuni: filtri, ordinamenti, varianti colore/taglia, paginazioni e pagine di categoria che cambiano spesso. Ogni combinazione può creare nuove URL, e molte di queste non meritano una visita regolare. I portali editoriali e i siti di annunci hanno un’altra complessità: contenuti che scadono, si spostano, cambiano stato (disponibile, venduto, archiviato) e generano molte pagine a bassa permanenza.
Nei marketplace la dinamica si amplifica: migliaia di schede prodotto simili, schede venditore, pagine di ricerca interne e sistemi di tracking che aggiungono parametri. Se l’architettura non guida Google verso le pagine “forti”, il bot finisce per disperdersi. E quando Google deve scegliere, spesso privilegia ciò che è più chiaro, più stabile e più collegato internamente.
Da qui nasce una conseguenza pratica: il crawl budget non è un argomento da addetti ai lavori solo per siti giganteschi. Anche un sito medio può sentirlo, se genera troppe URL di servizio senza intento di ricerca rispetto alle URL ottimizzate che dovrebbero portare traffico. A questo punto vale la pena capire come Google lo calcola, perché le leve su cui intervenire sono più concrete di quanto sembri.
Come Google calcola il crawl budget: componenti e segnali
Google decide quanto spingere sul tuo sito con un equilibrio che assomiglia a una trattativa silenziosa: da una parte c’è la capacità tecnica di reggere le visite del bot, dall’altra l’interesse reale che quelle pagine sembrano avere. Il crawl budget nasce dall’incrocio di questi due piani. E cambia nel tempo, perché cambia il sito, cambiano i segnali, cambiano persino gli errori che Google incontra lungo la strada.
Crawl rate limit: capacità del server, limiti di scansione e risposta
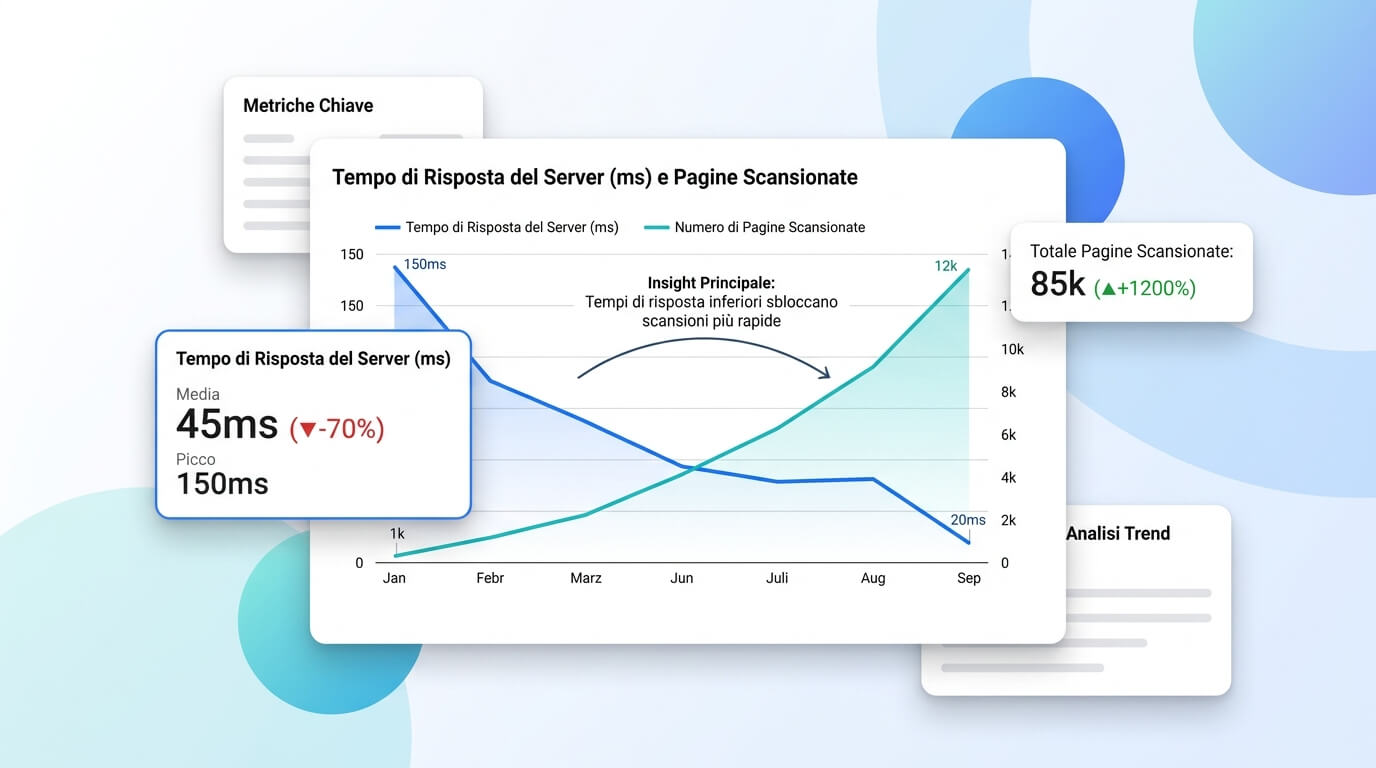
Il crawl rate limit è il freno di sicurezza. Googlebot può anche voler scansionare tante URL, ma se il server risponde lentamente o in modo instabile, rallenta. Non per gentilezza, ma per evitare di peggiorare le prestazioni del sito e sprecare richieste che finiscono nel nulla. Per questo, la salute tecnica conta quanto i contenuti: una casa piena di stanze interessanti resta difficile da visitare se la porta si inceppa ogni due minuti.
Ci sono segnali che, spesso, raccontano questa storia meglio di qualsiasi opinione: TTFB alto, picchi di errori 5xx, time-out, risposte che oscillano da una visita all’altra. Quando Googlebot incontra ostacoli ripetuti, tende a proteggersi riducendo la pressione. Il risultato è semplice e un po’ crudele: meno scansioni utili, più tempo per vedere le modifiche riflettersi in SERP.
Un dettaglio che sorprende molti: non serve andare giù per avere un problema. Anche una lentezza costante, ma moderata, può fare danni su siti con tante pagine, perché moltiplica il costo di ogni richiesta. Se Google impiega il doppio del tempo per scaricare una pagina, a parità di risorse finirà per visitarne molte meno.
Crawl demand: popolarità, freschezza e importanza delle URL
Se il crawl rate limit è quanto Google può scansionare, la crawl demand è quanto Google vuole scansionare. Qui entrano in gioco segnali di valore percepito: pagine che ricevono traffico, URL citate e linkate internamente con coerenza, contenuti che vengono aggiornati e che, storicamente, hanno dato risposte buone agli utenti.
La popolarità non è solo questione di backlink. Anche la struttura interna conta: se una pagina è sepolta, raggiungibile solo dopo molti clic, o collegata da sezioni poco rilevanti, Google la tratterà come una conoscenza di periferia. Al contrario, URL ben collegate dalle pagine centrali del sito e inserite in percorsi naturali di navigazione diventano candidate a visite più frequenti.
La freschezza è l’altra leva. Un sito di notizie, o un e-commerce con prezzi e disponibilità che cambiano, comunica a Google che vale la pena tornare spesso. Un sito generalmente statico può comunque costruire nuovo traffico organico se pubblica con regolarità e se le nuove pagine risolvono esigenze reali. Google, alla fine, ragiona da bibliotecario: aggiorna più volentieri lo scaffale che la gente consulta.
C’è poi un aspetto pragmatico: Google tenta di ottimizzare il rapporto tra tempo speso e qualità delle pagine trovate. Se il bot visita una sezione e trova molte URL simili, sottili o poco utili, la voglia di tornare si raffredda. Una volta che questa dinamica si innesca, non la curi con un singolo intervento, la rimetti in ordine dimostrando, nel tempo, che la scansione produce valore.
Qualità e stato delle URL: thin content, errori 4xx/5xx, redirect e aggiornamenti dell’indice
Il crawl budget non si consuma solo sulle pagine buone. Anzi, spesso si brucia su ciò che Google incontra per sbaglio: thin content, pagine vuote o quasi, archivi senza senso, risultati interni indicizzabili, duplicati che cambiano solo per un parametro. Ogni visita a una URL debole è tempo sottratto a una pagina che potrebbe portare traffico.
Gli errori 4xx e 5xx sono un’altra tassa. Un 404 occasionale è normale, soprattutto su siti che cambiano spesso. Il problema nasce quando le URL rotte sono tante e continuano a essere linkate internamente o presenti in sitemap. Googlebot ci torna, riprova, insiste. Il sito, intanto, paga due volte: in scansione sprecata e in segnale di disordine tecnico.
Lo stesso vale per i redirect. Un 301 pulito, singolo, verso una destinazione coerente è una soluzione elegante. Le catene, invece, sono un labirinto: URL A porta a B, che porta a C, e magari C torna indietro o cambia ancora. Ogni passaggio aggiunge latenza e aumenta la probabilità di errori. Su larga scala, quei millisecondi diventano minuti e poi ore di crawl buttate.
Infine c’è il rapporto tra scansione e aggiornamento dell’indice. Google può visitare una pagina e decidere di non aggiornare subito l’index se i segnali non sono chiari, se vede contenuti troppo simili o se la pagina sembra poco rilevante rispetto alle alternative. È un comportamento che manda in confusione: la pagina è stata letta, eppure non si muove nulla. In questi casi, la domanda utile non è quante volte Google arriva, ma cosa trova quando arriva.
Con questi pezzi sul tavolo, la parte interessante diventa capire quando tutto ciò smette di essere teoria e si trasforma in un problema concreto, visibile nei numeri e, soprattutto, nei tempi di indicizzazione.
Se hai pubblicato una nuova pagina e dopo giorni non la trovi ancora su Google, spesso il problema non è la qualità del testo. È che Google non è arrivato lì, o ci è arrivato e ha preferito spendere tempo altrove. Il crawl budget è proprio questo: quanta attenzione riceve il tuo sito e come viene distribuita tra pagine utili, duplicati, filtri e vicoli ciechi. È un tema da grandi siti, sì, ma anche da siti normali che crescono e, senza volerlo, iniziano a produrre troppe URL.
Quando il crawl budget diventa un problema reale
Finché Google scansiona e aggiorna il tuo sito con un ritmo sano, il crawl budget resta sullo sfondo. Il campanello suona quando vedi ritardi, buchi nell’indice e un bot che gira a vuoto, senza priorità. Perciò non è necessario inseguire Googlebot ma capire se sta investendo il suo tempo sulle pagine giuste che tu reputi importante.
Sintomi: nuove pagine che non entrano in indice e aggiornamenti lenti
Il sintomo più netto è la distanza tra ciò che pubblichi e ciò che Google indicizza. Nuove pagine che restano fuori settimane, oppure entrano e poi spariscono. Succede spesso su siti con molte pagine simili: Google scansiona, valuta, rimanda la decisione e intanto dà priorità ad altro.
L’altro segnale è la lentezza negli aggiornamenti. Cambi title, correggi contenuti, sistemi link interni, e in SERP resta tutto fermo. Se Googlebot passa raramente sulle URL importanti, ogni miglioramento impiega più tempo a produrre effetti. È frustrante perché sembra che il lavoro non conti, quando in realtà non viene letto con la frequenza necessaria.
Un indizio collaterale è vedere il bot concentrato su pagine che non ti interessano: risultati di ricerca interna, combinazioni di filtri, pagine con parametri, vecchie URL in redirect. Quando il crawling si disperde, la parte vitale del sito diventa una stanza in fondo al corridoio, visitata quando avanza tempo.
Siti piccoli vs siti grandi: soglie pratiche e casi d’uso
Un sito piccolo, con poche centinaia di URL pulite e ben collegate, di solito non soffre di crawl budget. Google riesce a scansionare tutto, anche se il server non è un fulmine, perché il mondo web da esplorare è limitato e l’architettura non genera duplicazioni in massa.
Le soglie diventano concrete quando le URL salgono, o quando il sito produce molte pagine quasi uguali. Un e-commerce con migliaia di prodotti e decine di combinazioni filtro può diventare grande per Google anche se, per te, è ancora gestibile. Un portale con tag, archivi e pagine di ricerca indicizzabili può gonfiarsi senza che nessuno lo noti, finché l’indice inizia a selezionare in modo più aggressivo.
Conta anche la velocità di cambiamento. Un sito con poche URL ma aggiornamenti frequenti può avere bisogno di scansioni regolari per riflettere prezzi, disponibilità o contenuti aggiornati. Qui il problema non è entrare in indice, è restare allineati con ciò che l’utente trova davvero sul sito.
Priorità SEO: quando conviene intervenire sul crawl budget e quando no
Intervenire ha senso quando il crawling impatta obiettivi visibili: indicizzazione lenta di pagine che potrebbero portare traffico, spreco sistematico su URL inutili, difficoltà a far recepire modifiche importanti. Se il sito è piccolo e stabile, la stessa energia spesso rende di più su contenuti, intenti di ricerca e linking interno di base.
Conviene anche quando hai appena fatto cambi strutturali: migrazioni, refactoring di categorie, nuove regole di URL, cleanup di filtri. In quei momenti il crawling diventa una questione di ordine: ridurre i vicoli ciechi aiuta Google a ricalcolare più in fretta cosa tenere e cosa lasciar fuori.
Se invece la Search Console mostra un’indicizzazione coerente, nessun ritardo anomalo e un sito senza esplosione di URL, il crawl budget può rimanere una nota a margine. Non è un badge di bravura tecnica, è un tema da affrontare quando il comportamento di Google lo rende necessario.
Come misurare e diagnosticare il crawl budget (dati e strumenti)
Il crawl budget si capisce dai dati, non a intuito. Per fortuna, ci sono tre fonti che, anche senza essere sviluppatori, permettono di farsi un’idea chiara: Search Console, log del server (se li hai) e un audit tecnico mirato alle URL che Google scansiona senza indicizzare.
Google Search Console: statistiche di scansione e lettura dei trend
In Search Console, le Statistiche di scansione sono il termometro: quante richieste fa Googlebot, quanta banda consuma, qual è il tempo medio di risposta. Il valore non è il numero assoluto, è la curva: se il volume cala quando pubblichi di più, o se i tempi di risposta crescono, qualcosa sta frenando.
Guarda anche i pattern: picchi improvvisi spesso seguono cambi sul sito (nuove sezioni, parametri, pagine generate). Crolli improvvisi possono accompagnare problemi server o molte risposte 5xx. È un modo semplice per legare un sintomo a un evento, senza dover inseguire ipotesi per giorni.
Se vuoi rimettere in fila le priorità SEO prima di entrare nei dettagli tecnici, questo video offre una panoramica utile per non dimenticare i controlli di base che spesso sbloccano anche la scansione.
Analisi log del server: segmentazione per bot/URL e frequenza di crawling
I log del server sono la radiografia più precisa: dicono quali URL Googlebot ha visitato davvero, quando e con quale risposta (200, 301, 404, 500). Se li puoi ottenere, anche solo per un campione di settimane, diventano oro. Ti mostrano la differenza tra ciò che pensi sia importante e ciò che Google sta effettivamente esplorando.
La parte che conta è la segmentazione: separare Googlebot dagli altri bot, raggruppare per directory (categorie, prodotti, filtri) e individuare le URL che assorbono più richieste. Se scopri che una grande fetta del crawling finisce su parametri, paginazioni profonde o redirect, hai già trovato uno spreco concreto.
Un ultimo uso pratico: confrontare la frequenza di crawling tra pagine “core” e pagine marginali. Se una categoria strategica viene scansionata raramente, mentre una pagina filtro viene visitata spesso, l’architettura sta mandando un segnale sbagliato. E Google lo sta seguendo alla lettera.
Copertura/Indicizzazione e sprechi: scegliere i KPI giusti
Nel report di Indicizzazione, la voce “Crawled – currently not indexed” è una delle più istruttive. Significa che Google è passato, ha letto la pagina, ma non l’ha messa in indice. Non è una condanna automatica: a volte è normale, spesso però segnala contenuti duplicati, pagine poco differenziate o URL generate senza un vero scopo.
Qui un audit tecnico SEO non deve diventare una caccia alle streghe. Serve a classificare: quante URL scansionate ma non indicizzate sono pagine che ti interessano davvero, e quante sono rumore. Se il c’è tanto caos, stai pagando crawl budget senza ottenere visibilità.
Per tenere il controllo nel tempo, scegli pochi KPI leggibili: rapporto tra pagine valide indicizzate e pagine escluse, velocità media di indicizzazione delle nuove URL, numero di errori 5xx durante i periodi di picco. Se quei numeri migliorano significa che la strategia SEO adottata è quella corretta.
Metti Googlebot sulla strada giusta
Il crawl budget non è un concetto astratto: è la quantità di attenzione che Google decide di concedere al tuo sito e, di conseguenza, la velocità con cui scopre, rilegge e (solo se lo ritiene opportuno) indica le pagine che contano. Se alla fine della tua analisi scopri che il bot spende tempo su URL ridondanti o poco utili, l’indicizzazione rallenta, gli aggiornamenti diventano meno reattivi e le pagine strategiche rischiano di restare in secondo piano significa che è arrivato il momento di intervenire.
La buona notizia è che puoi influenzare questa dinamica: rendi facile il lavoro al crawler, riduci gli sprechi e segnala in modo chiaro quali contenuti meritano priorità. Se il tuo sito sta crescendo o contiene molte pagine simili, è il momento giusto per controllare dove finisce davvero il tempo di Googlebot e rimettere ordine.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.