
Pubblicato il - Aggiornato il
Replit: cos’è, come funziona e perché usarlo per sviluppare rapidamente
AI

Se ti serve uno script per pulire dati, generare report o automatizzare un flusso operativo, aspettare settimane di sviluppo spesso non è un’opzione: qui entra in gioco Replit, un ambiente di coding nel browser pensato per prototipare, collaborare e mettere online piccoli tool in tempi molto più brevi. È particolarmente utile per founder, responsabili marketing e team di agenzia che vogliono trasformare un’idea in un output professionale senza perdersi in setup locali e dipendenze.
In questa guida vedremo esempi concreti e indicazioni chiare su implementazione, gestione dei segreti e governance dei dati, con un approccio pragmatico: cosa fare, cosa evitare e come mantenere controllo e sicurezza mentre si accelera. Partiamo dalle basi: cos’è Replit e a cosa serve davvero nel tuo stack operativo nell’era del vibe coding.
Indice dei contenuti
Cos’è Replit e a cosa serve (davvero) in un team che deve consegnare in fretta
Replit è un ambiente di sviluppo nel browser che ti permette di scrivere codice, installare dipendenze ed eseguire programmi senza configurare nulla in locale. Per chi lavora su marketing, dati e operations il valore non è imparare a programmare, ma ridurre l’attrito tra idea, prototipo e tool utilizzabile. In pratica: meno setup, più iterazione, più velocità nel validare un’ipotesi.
Un IDE nel browser: cosa trovi dentro (e perché fa risparmiare tempo)
Dentro Replit trovi un editor, un file system, un terminale e una preview dell’app (se stai costruendo qualcosa di web). Questo significa che puoi passare da “ho bisogno di uno script per normalizzare un CSV” a “lo script gira e restituisce un output” in pochi minuti, senza dover gestire Python, Node, librerie e versioni sul tuo laptop.
Per un team cross‑funzionale è utile anche perché standardizza l’ambiente: se uno script funziona nel Repl, è molto più probabile che funzioni anche per chi lo apre dopo. In ottica operativa, riduce le classiche frizioni tipo “a me funziona” / “a me no” dovute a dipendenze diverse o configurazioni locali inconsistenti.

I casi d’uso più comuni per marketing, dati e agenzia (e quelli da evitare)
Replit rende bene quando devi costruire micro-tool e automazioni: generatori di UTM, validator di tracking, script per estrazioni API, piccoli endpoint per integrare servizi, prototipi di dashboard “light” o utility interne per il team. Il punto non è sostituire un backend “serio”, ma creare un ponte veloce tra bisogno e soluzione testabile, misurando subito impatto sul tuo workflow.
Dove invece conviene frenare: progetti con requisiti stringenti di compliance, architetture complesse, o applicazioni che richiedono controlli avanzati su rete, identità, logging e segregazione degli ambienti. Replit può essere un ottimo acceleratore, ma non è automaticamente il posto giusto per tutto ciò che è ti sembra un problema critico.
Ecco una bussola pratica (senza complicarla troppo):
- Ideale per: prototipi, script data/SEO, automazioni, PoC con stakeholder, tool interni a bassa criticità.
- Meno ideale per: prodotti in produzione con requisiti enterprise, dati altamente sensibili, carichi elevati e costanti, esigenze avanzate di compliance/audit (se non sei un dev senior che sa esattamente come muoversi in ogni fase).
Come funziona Replit: concetti base da capire prima di scrivere una riga
Per usare Replit bene non serve conoscere ogni dettaglio della piattaforma, ma conviene capire tre concetti: cos’è un “Repl” (il tuo progetto), come vengono gestite le dipendenze e come gira l’esecuzione (script, web server, processi). Se hai questi fondamentali, eviti la maggior parte degli errori “da principiante” e ti muovi più veloce.
Repl, template e runtime: parti da una base pulita
Un Repl è, in sostanza, un progetto: file + configurazione + ambiente di esecuzione. Di solito parti da un template (Python, Node, HTML/CSS/JS, ecc.) e Replit ti prepara una struttura iniziale che puoi modificare.
Per lavori operativi conviene partire da template “semplici” e aggiungere complessità solo quando serve. Se stai facendo data tasks (es. chiamate API, parsing, pulizia), un Repl Python minimale spesso è più che sufficiente; se stai costruendo una piccola web app interna, un template web o Node ti mette in pista rapidamente.
Un vantaggio pratico: avere un template standard per il team (ad esempio “tool interno + README + gestione secrets + logging minimale”) ti permette di scalare la produzione di tool senza reinventare ogni volta le basi.
Dipendenze e ambiente: installare librerie senza impazzire (ma con metodo)
Replit gestisce le dipendenze in modo abbastanza guidato: per molti linguaggi puoi aggiungere pacchetti direttamente dall’interfaccia, oppure usare il terminale (pip, npm, ecc.). Dietro le quinte spesso entra in gioco una configurazione dell’ambiente (in alcuni casi basata su Nix), che rende più riproducibile ciò che installi.
Un principio da tenere sempre presente: la consegna non comprende soltanto il codice, ma anche l’ambiente che lo rende eseguibile. Mantieni un file chiaro (es. requirements.txt/pyproject.toml o package.json) e scrivi nel README come eseguire il progetto. È un investimento piccolo che riduce drasticamente tempi di handover e bug dovuti a mismatch di librerie.
Se il tool deve vivere nel tempo, evita di installare “a mano e basta”. Anche in Replit, la sostenibilità passa da documentazione minima e dipendenze versionate.
Esecuzione, porte e preview: cosa succede quando premi “Run”
Quando premi “Run”, Replit avvia il tuo codice in un ambiente isolato e ti mostra output e log nella console. Se il tuo progetto espone un web server, Replit gestisce la porta e ti offre una preview (o un link) per testare rapidamente l’applicazione.
Per chi lavora su automazioni, questo modello è utile perché puoi distinguere due casi:
- script “one-shot” (eseguo, ottengo output, finito);
- servizi “sempre attivi” (un endpoint o una web app da tenere online).
Questa distinzione impatta su costi, affidabilità e governance: uno script che gira quando serve è più semplice da controllare; un servizio esposto richiede più attenzione a sicurezza, rate limit, gestione errori e monitoraggio.
Come iniziare in modo operativo: dal primo Repl a un tool condivisibile
Aprire Replit e scrivere codice è facile; farlo in modo che il risultato sia riutilizzabile dal team è un’altra storia. Qui l’obiettivo è impostare un flusso di lavoro “snello” ma solido: struttura del progetto, gestione dei segreti, versioning. Bastano poche scelte giuste per evitare debito tecnico già alla prima settimana (leggi l’effetto valanga).
Struttura del progetto: README, input/output e “contratto” del tool
Se stai creando uno script o un micro-tool, pensa subito a come verrà usato: input, output, parametri, errori. Anche un tool di 50 righe diventa molto più utile se definisci un “contratto” chiaro: cosa gli dai e cosa ti restituisce.
Una struttura minima consigliata:
- un
README.mdcon scopo, requisiti e istruzioni di esecuzione; - una cartella
src/(o comunque file ordinati); - un esempio di input (o un mock) e un esempio di output.
Secrets e variabili d’ambiente
Molti tool nascono come prototipo e poi diventano “semi‑produzione” senza che nessuno lo decida davvero. Per questo la regola è semplice: gestisci i segreti bene dal minuto uno. API key, token, credenziali DB e webhook non devono mai finire in chiaro nel codice o nel README.
Imposta subito una strategia con variabili d’ambiente (Replit offre un sistema di secrets): il codice legge da env, e tu cambi i valori senza toccare i file. È anche il modo migliore per separare ambienti (test vs prod) senza duplicare progetti.
Checklist minima (rapida ma efficace):
- salva token/API key come Secrets e non nel codice;
- non committare file di configurazione con credenziali;
- usa nomi coerenti (
API_KEY,DB_URL,WEBHOOK_SECRET); - ruota le chiavi se le hai condivise in modo improprio;
- limita permessi delle chiavi (scope minimo necessario).
Collegare GitHub e versionare
Se il tool è “usa e getta” e rimane personale, puoi anche non complicarti la vita. Ma nel momento in cui un Repl diventa condiviso, o deve essere riutilizzato su più clienti/progetti, avere un flusso di versioning cambia tutto: puoi tracciare modifiche, fare rollback, fare review.
Collegare GitHub è utile anche per governance: chi ha cambiato cosa, quando, e perché. In un team di agenzia, inoltre, riduce la dipendenza dalla singola persona: il progetto vive in un repo, con issue e documentazione, e Replit diventa l’ambiente di esecuzione/prototipazione.
Un buon compromesso pragmatico: GitHub per tutto ciò che è “tool interno” o “asset di progetto” (anche piccolo), niente GitHub per esperimenti veloci che non superano la fase di prova.

Replit AI: come usarlo per accelerare senza perdere controllo
Le funzionalità AI di Replit possono ridurre molto il tempo tra idea e prima versione funzionante: generazione di snippet, spiegazioni del codice, suggerimenti mentre scrivi. Per chi deve consegnare tool e automazioni, il valore è soprattutto nella fase di “bootstrapping”: creare struttura, funzioni base, test e refactor. Ma va governato: l’AI non è un sostituto di review, sicurezza e validazione.
Replit Agent: trasformare una descrizione in un’applicazione funzionante
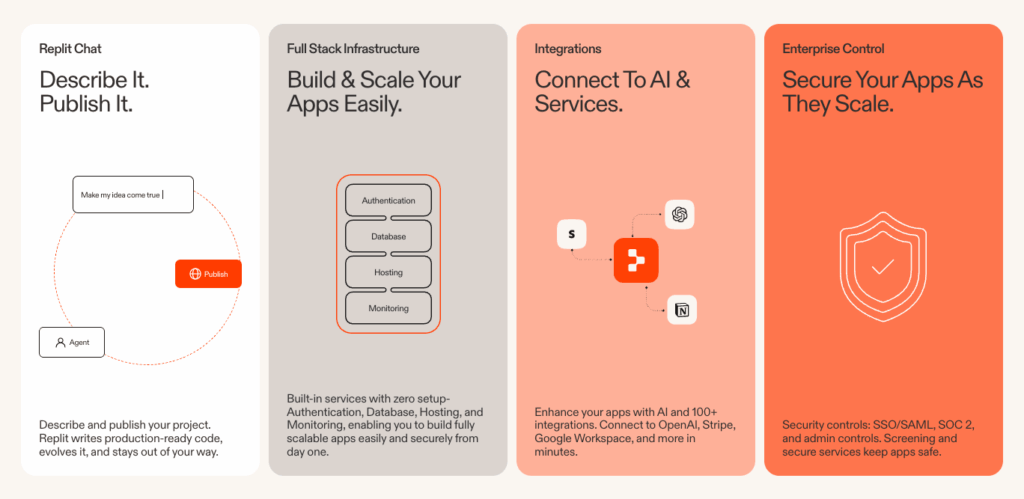
Replit Agent è l’assistente AI pensato per gestire un progetto partendo da una richiesta in linguaggio naturale. Puoi descrivere il tool che vuoi costruire, indicare le funzionalità principali e lasciare che Agent proponga la struttura, generi il codice, configuri l’ambiente e iteri sulla soluzione mentre la provi.
Il suo punto di forza è comprimere la distanza tra idea e prima versione utilizzabile: per esempio puoi chiedergli di creare una dashboard interna, un’app per validare file CSV o un piccolo servizio collegato a un’API. Durante il lavoro conviene procedere per richieste incrementali, controllando la preview e verificando a ogni passaggio che logica, interfaccia e gestione degli errori corrispondano davvero ai requisiti.
Agent non elimina la necessità di supervisione. Prima di condividere o pubblicare il progetto, controlla il codice generato, i permessi, le dipendenze, le chiamate esterne e l’eventuale uso di dati sensibili. I Secrets devono restare nelle variabili d’ambiente e ogni modifica importante dovrebbe essere testata e, quando il tool diventa condiviso o critico, versionata su GitHub.
Un altro aspetto da considerare è la possibilità di scegliere, quando previsto dalla configurazione e dal piano, tra diversi modelli AI disponibili in Replit, inclusi modelli open-weight. Questa scelta può aiutare a bilanciare qualità, velocità, costi e requisiti di privacy; non significa però che il modello venga eseguito automaticamente in locale o che i dati siano esclusi da qualsiasi trattamento esterno: verifica sempre provider, condizioni d’uso e impostazioni del progetto prima di inviare codice o informazioni sensibili.
Dove l’AI accelera: boilerplate, refactor e test
Se l’obiettivo è creare rapidamente un tool, l’Intelligenza Artificiale è utile per produrre boilerplate: parsing input, gestione errori, wrapper per chiamate API, piccole interfacce web, o conversione di uno script in una mini‑API. È anche utile quando devi tradurre una logica “di business” in codice: “prendi questi campi, normalizza, valida, esporta”.
Un uso molto concreto in ambito dati/marketing è far generare all’AI una prima versione di funzioni ripetitive (validazione di UTM, mapping di eventi, pulizia di naming). Poi però devi verificare: test su dataset reali, edge case, encoding, e soprattutto controllare che non stia introducendo assunzioni sbagliate sul tuo dataset.
Il modo più sano di usarla è considerarla un acceleratore di iterazione: tu definisci requisiti e controlli, l’AI propone una bozza, e tu fai validazione e rifinitura.
Limiti e rischi: qualità del codice, licenze, dati sensibili
Il rischio principale non è “l’AI sbaglia una riga”, ma che tu la metta in produzione senza accorgerti di bug logici, falle di sicurezza o dipendenze inutili. Inoltre, se nel prompt inserisci dettagli sensibili (token, dati utente, esportazioni), stai creando un problema di governance dei dati: anche quando sembra comodo, non è una scorciatoia sostenibile.
Sul piano pratico: fai attenzione a tre aree. Primo, sicurezza (input non validati, injection, gestione errata di credenziali). Secondo, performance (loop inefficienti su dataset grandi, chiamate API non paginante, mancanza di caching). Terzo, compliance/licensing: evita di generare e incorporare codice senza capire cosa stai includendo e se è compatibile con le policy del tuo progetto.
Un buon principio operativo: usa l’AI per generare, ma mantieni tu la responsabilità su review, test e decisioni architetturali. Se il tool tocca tracciamenti, billing o dati utenti, alza l’asticella: code review e test non sono opzionali.
Sicurezza e governance dei dati: come evitare che un prototipo diventi un rischio
Quando lavori veloce è facile che un Repl diventi “il posto dove gira una cosa utile” e poi, senza accorgertene, diventi un pezzo di infrastruttura. Per evitare sorprese serve una base minima di sicurezza: gestione accessi, segreti, confini chiari su quali dati entrano nel tool, e un minimo di controllo su cambi e responsabilità. Non serve burocratizzare: serve mettere paletti intelligenti.
Accessi, permessi e condivisione: collaborazione sì, esposizione no
Replit rende semplice condividere un progetto, ed è un bene. Ma la condivisione va gestita con criterio: chi può vedere il codice? chi può eseguire? chi può modificare? Se un tool contiene logiche di business o integra sistemi esterni, non trattarlo come un link pubblico da inoltrare in chat.
In generale, separa “condivisione per review” da “condivisione per utilizzo”. Per esempio: puoi mantenere privato il codice e offrire un’interfaccia (anche minimale) a chi deve usarlo, oppure creare un Repl “runner” che chiama un servizio e non espone le parti sensibili. Questo riduce il rischio che informazioni su endpoint, key o logiche interne finiscano dove non devono.
Se lavori su più clienti, evita assolutamente di mescolare credenziali e dati nello stesso progetto: anche quando “tanto è solo un prototipo”, stai costruendo debito che prima o poi paghi.
Dati sensibili: cosa tenere fuori (e come impostare una baseline sostenibile)
Regola semplice: nel Repl non dovrebbero entrare dati personali o dataset completi se non hai una ragione forte e una policy chiara. Per molte automazioni marketing/analytics puoi lavorare con dati aggregati, campioni, o mascherati. Se devi usare dati reali (ad esempio per validare un funnel o un export), riduci la superficie: minimizza colonne, anonimizza dove possibile, e limita la persistenza.
Dal punto di vista operativo, crea una baseline di progetto:
- il Repl contiene codice e configurazione, non dati permanenti;
- i secrets vivono nel sistema di Secrets e non nel repo;
- log e output non includono PII o token.

Questo approccio è coerente con un lavoro data‑driven: misuri e ottimizzi, ma tieni sotto controllo ciò che raccogli e dove lo conservi.
Logging e tracciabilità: rendere un tool “manutenibile” anche se piccolo
Un tool senza logging è un tool che, quando si rompe, ti fa perdere tempo. Non serve costruire un sistema enterprise: basta un livello minimo di osservabilità. Log chiari sugli step principali, messaggi d’errore leggibili, e un modo per capire rapidamente se il problema è input, dipendenza, rete o permessi.
In più, se il tool ha impatto sul tuo lavoro (es. automatizza reportistica, invia eventi, aggiorna un foglio usato per decisioni), il tempo risparmiato diventa parte della qualità dei tuoi processi. Avere un changelog (anche solo via commit su GitHub) e un owner interno per ogni Repl “attivo” evita il classico scenario: tool utile, nessuno sa più come funziona, e ogni modifica diventa rischiosa.
Come sto utilizzando Replit per alzare il livello del mio lavoro
Ho iniziato ad utilizzare Replit nel 2025, individuandolo come una piattaforma estremamente versatile per lo sviluppo di soluzioni interne. La sua facilità d’uso e scalabilità lo hanno reso ideale per la realizzazione di tool personalizzati, adattati alle esigenze specifiche del mio workflow aziendale.
Dopo appena due mesi di utilizzo, mi sono reso conto che i token inclusi nel piano premium non erano sufficienti per soddisfare la crescente domanda generata dai miei progetti. Pertanto, ho scelto di investire regolarmente un budget mensile variabile tra i 300 e i 500€, destinato esclusivamente alla creazione e al miglioramento delle soluzioni personalizzate. Questo approccio mi ha permesso di sfruttare al massimo le potenzialità offerte da Replit.
Tra i principali tool sviluppati grazie alla piattaforma, si distinguono:
- Scraper avanzato su misura, progettato per estrarre dati in modo preciso e automatizzato;
- Generatore di idee con funzionalità potenziate, utile per la creazione di approcci innovativi;
- Sistema di gestione clienti centralizzato, ottimizzato per l’organizzazione e il monitoraggio delle relazioni con il cliente;
- Tool di AI generativa ad alte prestazioni, per la produzione di contenuti dinamici e personalizzati;
- Strumento di machine learning predittivo applicato alla SEO, dedicato all’ottimizzazione strategica dei contenuti;
- Tool per analisi avanzate, mirato a supportare decisioni basate sui dati.
L’adozione di Replit come piattaforma centrale ha trasformato il mio approccio allo sviluppo tecnologico, permettendomi di costruire soluzioni scalabili e performanti integrate con le principali API come OpenAI, Gemini, Claude, etc.
Grazie alla sua flessibilità e alle funzionalità avanzate, sono riuscito a ottimizzare i processi interni, generando un impatto positivo sia in termini di produttività che di competitività, e aumentare la qualità dei servizi offerti ai miei clienti.
Dall’idea al tool: quando Replit diventa parte di un progetto più grande
Replit è particolarmente efficace quando devi trasformare rapidamente un’esigenza operativa in qualcosa di concreto: uno script, un tool interno, una piccola applicazione o un primo prototipo da mettere nelle mani di chi dovrà realmente utilizzarlo.
Ma il passaggio più interessante arriva dopo il prototipo.
Quando quel tool deve iniziare a dialogare con CRM, gestionali, database, documenti o API aziendali, serve progettare una soluzione che rimanga comprensibile, modificabile e utile nel tempo.
È proprio l’approccio che utilizzo nello sviluppo di piattaforme AI custom: partire da un problema concreto, costruire una prima parte utilizzabile e aggiungere progressivamente automazioni, integrazioni e funzionalità AI dove generano davvero valore.
Lo stesso principio può essere applicato anche al web. Quando l’obiettivo è andare oltre il classico sito e introdurre ricerca semantica, assistenti basati sui propri contenuti o automazioni integrate nei flussi aziendali, lavoro invece su siti web AI-native.
Replit, in entrambi i casi, è uno strumento. Il vero vantaggio sta nel riuscire a ridurre la distanza tra un problema reale e una soluzione che le persone possono iniziare a usare.
Tag: Strumenti per il web
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.