
Pubblicato il
Embedding SEO: come analizzare il significato semantico del tuo sito
SEO
Hai mai notato che due pagine possono parlare delle stesse cose, con parole diverse, eppure una si posiziona e l’altra resta invisibile? È tutto una questione di significato. Con gli embedding, testi e query vengono trasformati in vettori che descrivono la vicinanza tra concetti. Immagina ogni parola o documento come una traduzione numerica, una sequenza di numeri in uno spazio multidimensionale. In questo spazio, la vicinanza semantica diventa cruciale: parole o pagine web con significati simili, come “auto” e “vettura”.
I modelli di intelligenza artificiale utilizzano la similarità del coseno per determinare la vicinanza concettuale tra testi. È il tipo di lettura che oggi conta: meno ossessione per la keyword identica, più capacità di intercettare intenti, sfumature, relazioni tra argomenti.
Gli embedding mettono ordine senza irrigidire: ti permettono di disegnare una mappa semantica dei topic del sito, vedere come sono distribuiti (e dove mancano pezzi), misurare la distanza tra pagine e query reali, e scegliere interventi che migliorano insieme posizionamento ed esperienza utente. Si avanza dalla produzione di contenuti al progetto editoriale SEO, definendo priorità chiare e visibilizzando i gap.
Indice dei contenuti
Embedding SEO e ricerca semantica: definizione e perché contano
Gli embeddings nella SEO servono a trasformare parole, frasi e intere pagine web in numeri. Più precisamente, in vettori che rappresentano il significato di un contenuto.
Questo permette ai motori di ricerca di andare oltre la semplice corrispondenza tra parole chiave. Due contenuti possono utilizzare termini differenti e, allo stesso tempo, parlare dello stesso argomento o rispondere a esigenze molto simili.
Gli embeddings rappresentano questa relazione in uno spazio matematico: più due contenuti sono simili nel significato, più i loro vettori saranno vicini.
Ed è qui che la cosa diventa interessante per la SEO.
Possiamo misurare quanto una pagina è coerente con un tema, con un intento di ricerca o con determinate query senza limitarci a contare quante volte compare una keyword.
Google, del resto, utilizza sistemi di machine learning per interpretare il contenuto nel suo insieme. Ripetere ossessivamente la stessa parola chiave perde quindi importanza: ciò che conta è costruire un contenuto capace di coprire in modo pertinente il tema e le sue relazioni concettuali.
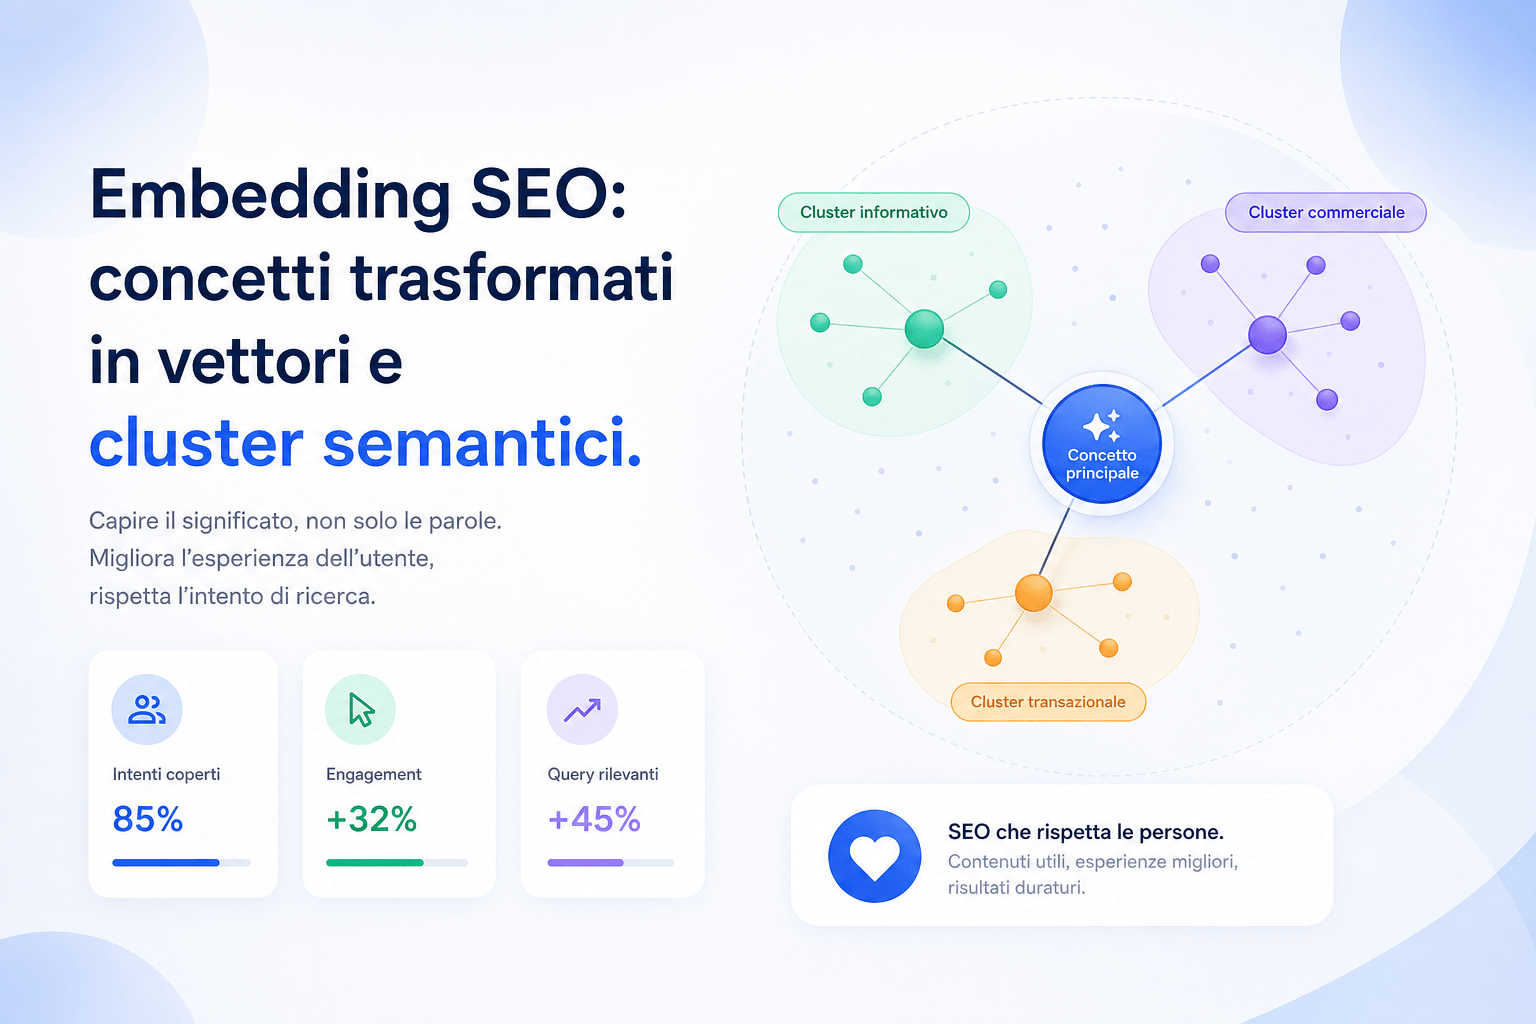
Keyword matching vs ricerca semantica e intento di ricerca
Il keyword matching riguarda l’uso delle stesse parole. Funziona ancora in parte, ma ti lascia scoperto quando le persone usano sinonimi, perifrasi, sigle, o quando cercano con domande lunghe e specifiche. Nel B2B e nell’e-commerce succede spesso: prodotti e soluzioni cambiano nome a seconda del reparto, del paese, del livello di competenza.
La ricerca semantica, invece, prova a capire l’intento di ricerca: informarsi, confrontare, scegliere, risolvere un problema. Gli embeddings aiutano qui, perché avvicinano testi che parlano dello stesso bisogno anche se usano parole diverse.
Word, sentence e document embeddings: dai vettori allo spazio semantico
Un embedding è una rappresentazione numerica di un testo. Una parola, una frase o un intero documento diventano una lista di numeri, un vettore, che funge da fotografia matematica del significato. Nel contesto della SEO e dell’Intelligenza Artificiale, questa tecnologia permette ai motori di ricerca come Google di analizzare il significato semantico delle parole e delle frasi, andando oltre la semplice corrispondenza esatta delle parole chiave. Non è un codice segreto, ma uno strumento potente per fare confronti più profondi e accurati.
Con i word embeddings misuri la vicinanza tra termini; con i sentence embeddings confronti frasi e query; con i document embeddings lavori su pagine intere, categorie, schede prodotto, articoli. In SEO, spesso la granularità migliore è quella “pagina”, perché è lì che decidi cosa indicizzare, cosa consolidare, cosa spingere con internal linking.
Per confrontare questi vettori si può utilizzare la similarità coseno (cosine similarity), una metrica che misura quanto due vettori sono orientati nella stessa direzione. In genere, più alto è il valore, maggiore è la similarità rilevata dal modello. Non esiste però una soglia universale che stabilisca quando due pagine siano “troppo simili”: il dato va interpretato nel contesto e confrontato tra contenuti elaborati con lo stesso modello.
Embeddings e motori di ricerca: ruolo e implicazioni per la SEO
I motori di ricerca usano da anni segnali semantici per collegare query e documenti. Non serve conoscere i dettagli interni: il punto operativo è che Google è diventato più bravo a premiare pagine che coprono un tema in modo coerente, non pagine che ripetono una formula.
La conseguenza per chi fa SEO è chiara: puoi continuare a lavorare con keyword, title e H1, ma la differenza spesso la fai con la copertura tematica, la struttura del sito e la gestione delle pagine simili. Gli embeddings ti danno un modo misurabile per verificare questa coerenza.
Use case di embedding SEO per SEO e content strategy
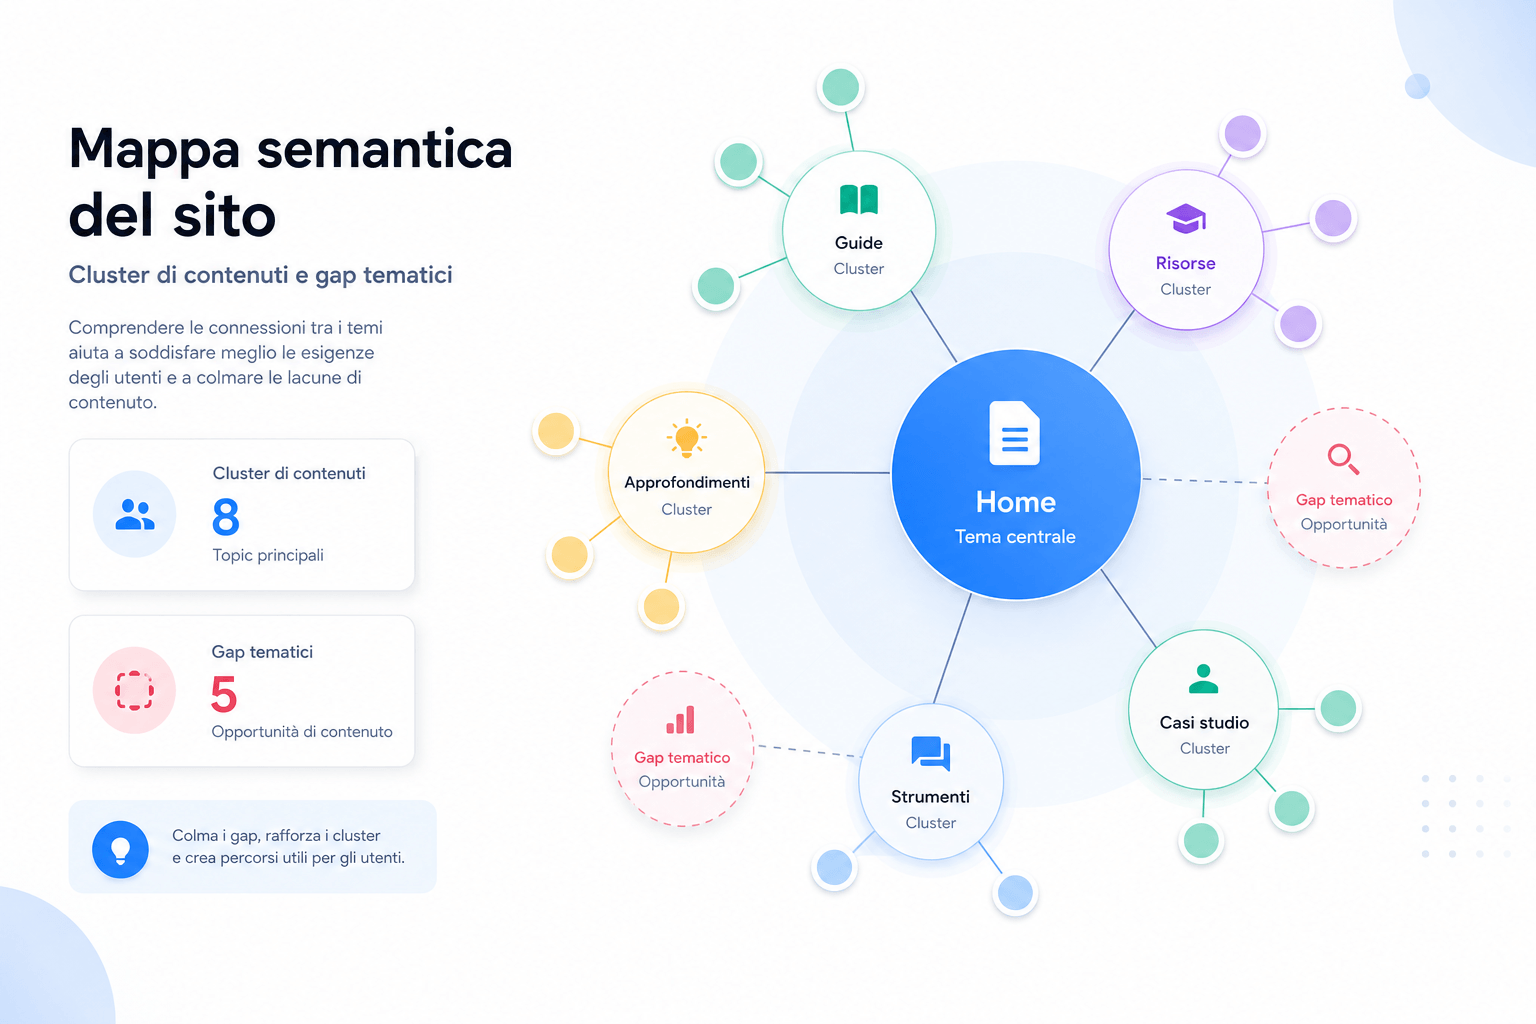
Gli embedding diventano utili quando producono decisioni: cosa creare, cosa aggiornare, cosa unire, cosa collegare. Qui entrano in scena le mappe: non mappe concettuali disegnate a mano, ma una mappa semantica che mostra come i topic sono distribuiti nel sito e dove si aprono i vuoti.
Se lavori con team diversi, questo è un vantaggio enorme. Perché porta tutti a discutere su cluster e priorità, non su opinioni.
Content gap analysis semantica e clustering delle SERP
Il content gap classico guarda keyword mancanti. Quello semantico guarda aree di significato non presidiate. Puoi clusterizzare le query o le pagine dei competitor in base alla similarità e confrontarle con i tuoi URL: se un cluster è popolato in SERP e nel tuo sito è vuoto o debole, hai un gap concreto.
Esempio: analizzando le pagine posizionate per un gruppo di query potresti trovare un cluster dedicato ai “costi della consulenza SEO” ben rappresentato tra i competitor, ma quasi assente sul tuo sito. Non hai semplicemente trovato una keyword mancante: hai individuato un’area tematica poco coperta.
La mappa semantica aiuta anche a evitare un errore comune: creare dieci articoli “vicini” tra loro perché sembrano idee diverse, ma per Google sono lo stesso tema. Il gap non si chiude moltiplicando pagine, si chiude progettando contenuti che coprono sotto-temi distinti.
Ottimizzazione di pagine simili: cannibalizzazione e consolidamento
Due pagine che si somigliano troppo spesso si rubano visibilità. Gli embedding ti permettono di misurare questa somiglianza su larga scala e di trovare coppie o gruppi sospetti: contenuti duplicati, categorie sovrapposte, varianti che dovevano differenziare ma non differenziano.
Esempio: immagina due pagine dedicate a “consulente SEO Milano” e “consulenza SEO a Milano”. Se mostrano una similarità semantica molto alta e intercettano anche query simili in Google Search Console, potrebbe esserci una sovrapposizione da analizzare. Non significa automaticamente cannibalizzazione, ma è un buon punto da cui partire.
Quando individui un gruppo, hai tre mosse tipiche: consolidare (unire in una pagina più forte), specializzare (rendere ogni pagina più diversa, coprendo intenti distinti), oppure deindicizzare ciò che non porta valore. Senza una misura semantica rischi di ottimizzare “a occhio” e di spostare il problema di qualche URL più in là.
Internal linking e brief/outlines basati su cluster tematici
Avere cluster ben definiti trasforma l’internal linking da semplice dettaglio a vera e propria architettura: unisci pagine correlate, crei itinerari strutturati, e potenzi hub e spoke. Utilizzando gli embedding, è possibile proporre collegamenti tra pagine che condividono lo stesso significato, anche in assenza della stessa keyword. Questo approccio all’embedding SEO permette di ottimizzare la navigazione e migliorare l’esperienza utente, creando una rete di contenuti coesa e significativa.
Strumenti e stack per vector embedding SEO
Per fare vector embedding in ottica SEO serve uno stack semplice ma solido: estrai i contenuti in modo pulito, li trasformi in numeri (vettori) e poi li interroghi per tirare fuori insight utili a ranking e conversioni. Qui Screaming Frog è il “coltellino svizzero” per raccogliere URL, title, H1, copy, status code e segnali interni senza perdere tempo in export manuali. In pratica: prima metti ordine nei dati, poi inizi a ragionare sul significato. Se il crawl è sporco (contenuti duplicati, template che “mangiano” il testo, pagine thin), anche gli embedding saranno poco affidabili: meglio saperlo subito.
Il secondo pezzo è Python, perché ti permette di automatizzare e validare ogni step: pulizia testo, rimozione boilerplate, chunking (spezzare una pagina in blocchi sensati), calcolo embedding e analisi delle distanze. Spesso bastano pandas, numpy e una libreria per chiamare un modello di embedding, più un indice vettoriale per cercare similitudini in modo veloce. L’obiettivo non è la spettacolarità, ma una pipeline replicabile che produca KPI SEO e decisioni: “quali pagine si cannibalizzano?”, “dove ho gap semantici?”, “quali cluster hanno performance sotto media?”.
Gli LLM entrano in gioco come acceleratore, non come bacchetta magica: puoi usarli per riassumere pagine, generare label dei cluster o proporre ipotesi di intent, ma sempre con una fase di controllo umano e con tracciamento delle fonti. La combo ideale è: embedding per misurare vicinanze reali, LLM per trasformare quelle vicinanze in azioni editoriali comprensibili (brief, outline, suggerimenti di internal linking). In questo modo umanizzi i dati: la strategia nasce dai numeri, ma si traduce in contenuti e architettura che parlano ai bisogni delle persone.
- Screaming Frog: crawl + estrazione di contenuti (HTML, main content, meta, link interni) e export strutturati per URL.
- Python: pulizia testi, chunking, calcolo embedding, clustering e report automatici (pronti per dashboard).
- Modello di embedding (API o locale): per ottenere vettori coerenti e confrontabili nel tempo, con log di versioni e costi.
- Database/indice vettoriale: per ricerca semantica rapida e deduplica (es. “pagine troppo simili” a soglia).
- Output su Data Studio/Sheets: per condividere performance e priorità con team SEO, content e CRO.
Screaming Frog + embeddings: configurazioni e output utili
Screaming Frog è la base operativa perfetta per portare gli embedding “nel mondo reale”, perché ti consente di raccogliere in modo pulito testo, metadati e segnali on-page su tutte le URL. La configurazione che funziona meglio è: crawl completo (anche JS se serve), estrazione dei contenuti principali e normalizzazione dei dati, così gli embedding non vengono “inquinati” da menu, footer e ripetizioni. In pratica stai preparando un dataset coerente: ogni riga una pagina, ogni colonna un’informazione utile per interpretare il significato. Questo è il passaggio che trasforma l’audit da lista di errori a insight azionabili.
A livello di setup, l’obiettivo è generare output che puoi arricchire con vettori e poi leggere in chiave SEO/CRO: cluster, pagine troppo simili, gap tematici, incoerenze tra title e contenuto. In Screaming Frog conviene usare Custom Extraction (CSSPath, XPath o Regex) per estrarre solo il blocco “main content” e non tutto l’HTML, e attivare l’export che ti serve per lavorare in Python/Sheets/Looker Studio. Se il sito è grande, imposta limiti e scheduling: meglio un crawl sostenibile e ripetibile (KPI stabili) che uno “eroico” ma ingestibile. La metrica che cerchi dopo è la distanza semantica tra URL (e tra URL e query), non l’ennesima lista di tag mancanti.
Ecco gli output più utili da far uscire da Screaming Frog (o da preparare per l’arricchimento con embedding), quelli che di solito sbloccano decisioni rapide su contenuti e architettura:
- URL + Title + H1 + Meta description: per confrontare promessa (SERP) e contenuto reale, e scovare pagine “fuori tema”.
- Estratto del main content (testo pulito): è la base per calcolare embedding affidabili e fare clustering senza rumore.
- Inlinks/Outlinks e depth: ti servono per capire se i cluster semantici sono anche supportati da una struttura interna coerente (SEO + UX).
- Status code, canonicals e indexability: perché la semantica conta solo se le pagine sono effettivamente indicizzabili.
- Dati di performance (se integri GSC/GA4): per collegare cluster semantici a KPI reali (click, CTR, conversioni).
Una volta esportato tutto, l’uso pragmatico è questo: calcoli gli embedding sul testo estratto, misuri similarità tra pagine e ti crei una mappa che evidenzia cannibalizzazioni, contenuti duplicati “di significato” e opportunità di consolidamento. Poi incroci con GSC: se due URL sono vicinissime semanticamente ma competono sulle stesse query, hai un caso concreto da risolvere (merge, redirect, rilancio, o differenziazione dell’intento). Il valore qui non è fare velocemente con l’AI, ma costruire un metodo per che trasformare queste informazioni in decisioni strategiche e generare performance di crescita misurabili.
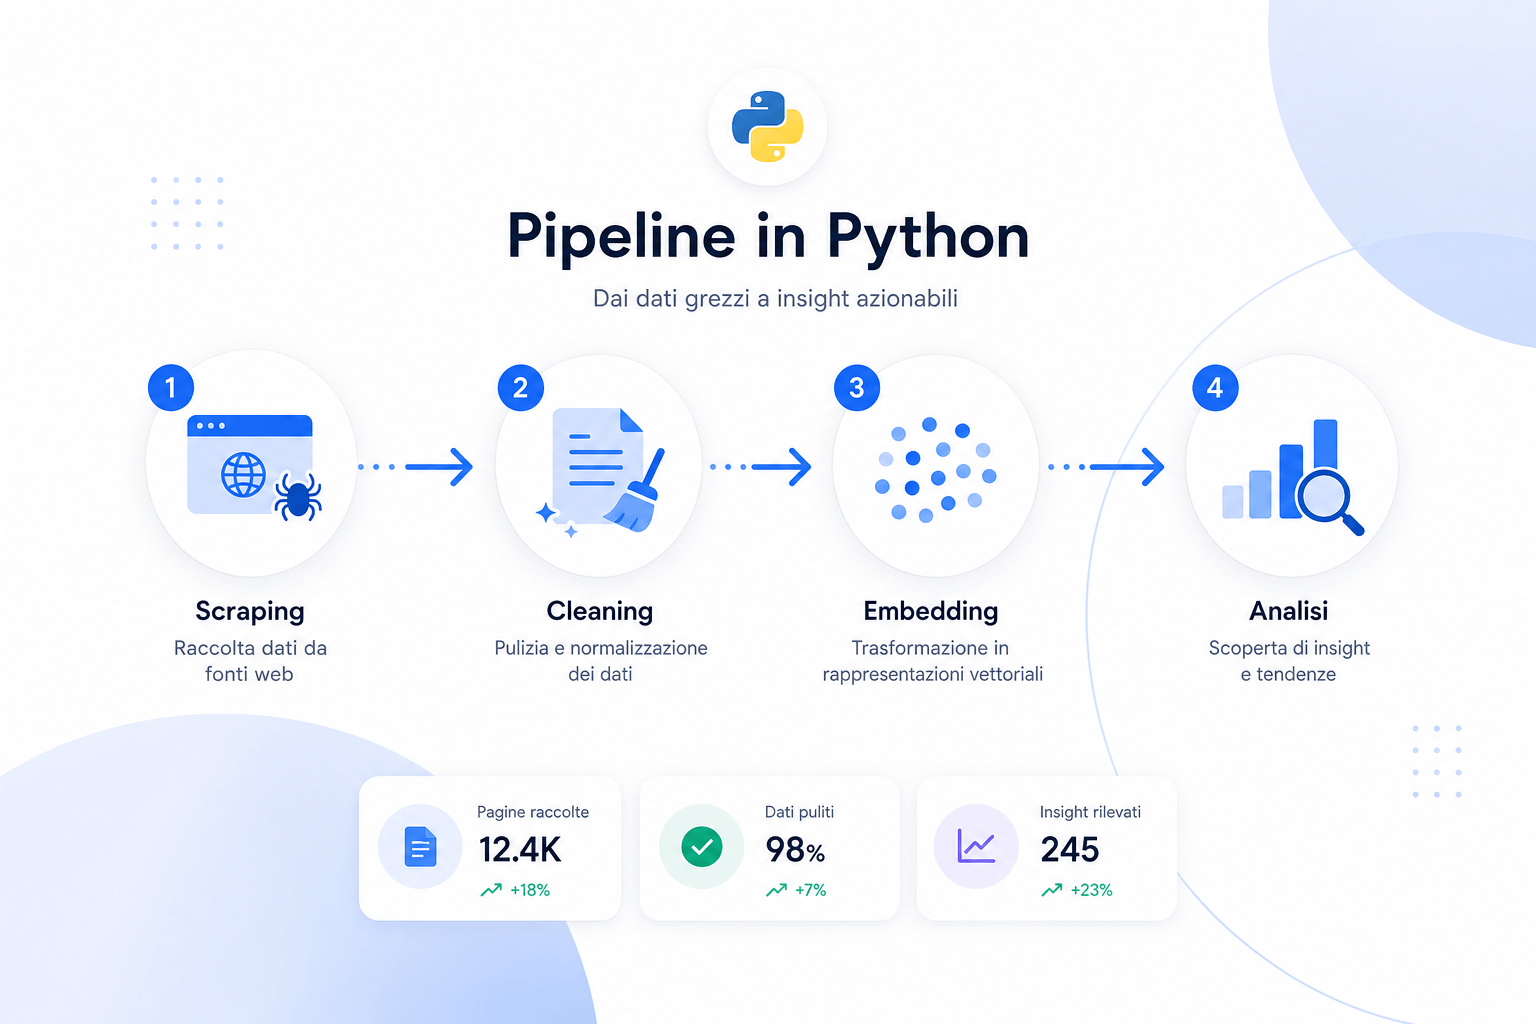
Pipeline in Python: scraping, cleaning, embedding e analisi
Per trasformare gli embedding in decisioni SEO concrete, serve una pipeline in Python semplice ma robusta: prima raccogli i testi (scraping o export), poi li rendi “leggibili” alla macchina (cleaning), quindi calcoli i vettori (embedding) e infine fai analisi per ottenere insight utili su cluster, sovrapposizioni e gap. L’obiettivo non è fare data science “da laboratorio”, ma costruire un flusso ripetibile che ti permetta di aggiornare la mappa semantica del sito ogni volta che cambiano contenuti, categorie o priorità. In pratica: dai dati grezzi a una vista strutturata di come i contenuti del sito coprono temi, intenti e relazioni semantiche rilevanti per la ricerca.
La parte di scraping può partire da una sitemap, da un crawl (tipo Screaming Frog) o direttamente dal CMS, scegliendo cosa estrarre: title, H1, testo principale, anchor, breadcrumb. Nel cleaning si gioca la qualità del risultato: elimini boilerplate (menu, footer), normalizzi spazi e encoding, e soprattutto decidi “quanto testo” rappresenta una pagina senza distorcerla (es. solo main content, niente recensioni ripetute). Qui conviene anche salvare tutto in un dataset versionato (CSV/Parquet) con URL, template, lingua e timestamp, così puoi misurare evoluzioni e impatto sulle performance.
A quel punto generi gli embedding (API o modelli locali) e li unisci alle metriche SEO/analytics: impression, click, CTR, posizione media, conversioni, revenue, log di ricerca interna. Con i vettori puoi calcolare similarità (coseno), fare clustering e creare una “mappa” dove le pagine vicine parlano davvero di cose simili, anche se usano parole diverse. Ecco una sequenza pratica che funziona bene nella maggior parte dei progetti:
- Raccolta URL e contenuti: sitemap/crawl + estrazione del main content
- Cleaning e normalizzazione: rimozione boilerplate, deduplica, lingua, stop a testi “rumorosi”
- Calcolo embedding: per pagina e/o per blocchi (utile su pagine molto lunghe)
- Analisi semantica: similarity matrix, cluster, outlier, cannibalizzazioni potenziali
- Join con KPI: priorità basate su traffico, conversioni e opportunità di CRO
Il punto chiave è la fase di analisi: non basta “vedere i cluster”, bisogna tradurli in azioni—unire pagine troppo simili, differenziare intenti, creare contenuti ponte, rafforzare internal linking tra pagine semanticamente vicine ma scollegate. E attenzione ai limiti: gli embedding misurano significato, non qualità editoriale né autorevolezza; per questo la validazione va fatta incrociando risultati con SERP reali, query che portano traffico e segnali di comportamento (scroll, bounce, conversioni). È qui che il metodo diventa sostenibile: iteri, misuri, aggiorni la pipeline e costruisci una strategia basata su evidenze, non su supposizioni.
Vector database, retrieval e integrazione con BI e LLM per team SEO
Quando gli embedding iniziano a essere tanti (URL, query, snippet, recensioni, ticket, FAQ), serve un posto intelligente dove salvarli e interrogarli: qui entra in gioco il vector database. A differenza di un database classico, non cerchi la stessa parola, ma i contenuti più vicini per significato, con una ricerca semantica veloce e scalabile. Per un team SEO significa passare da analisi spot a un sistema che risponde a domande operative tipo: “quali pagine stanno competendo tra loro?”, “quali query sono semanticamente coperte ma non performano?” o “quali topic mancano davvero nel cluster?”.
Il pezzo chiave si chiama retrieval: prima recuperi dal vector DB i contenuti più pertinenti (pagine, sezioni, entità, SERP snapshot), poi li usi per generare insight o azioni concrete. È lo stesso principio del RAG (Retrieval-Augmented Generation), ma applicato alla SEO: l’LLM non genera più allucinazioni, lavora su evidenze recuperate dal tuo sito e dai tuoi dati, con citazioni e tracciabilità. In pratica puoi costruire un assistente che propone ottimizzazioni on-page, suggerisce internal linking, o evidenzia cannibalizzazioni, sempre partendo da un set controllato di fonti.
Per farlo funzionare davvero in azienda, l’integrazione con la BI (tipo Data Studio o dashboard su BigQuery) è ciò che trasforma la tecnologia in decisioni. Il vector DB diventa un layer semantico, mentre la BI resta il layer dei KPI: li colleghi e ottieni priorità basate su impatto, non su sensazioni. Esempi pratici di cosa puoi mettere in produzione:
- Similarità tra URL per scovare cannibalizzazioni e duplicazioni “di senso”, non solo di testo
- Matching query–pagina per migliorare keyword mapping, title/H1 e struttura dei contenuti
- Gap semantici di cluster incrociati con impression/click (GSC) e conversioni (GA4/CRM)
- Recupero di evidenze (snippet, paragrafi, FAQ) per alimentare prompt e brief editoriali verificabili
- Alert predittivi: pagine che si allontanano dal topic del cluster o perdono copertura di intenti
Il limite da dichiarare è semplice: senza governance dei dati (cosa indicizzi, ogni quanto aggiorni, quali fonti sono “gold”), l’AI amplifica confusione. Con un minimo di metodo, invece, ottieni un workflow sostenibile:
ingestione → embedding → vector DB → retrieval → dashboard + LLM.
Risultato: insight più rapidi, priorità più chiare e un team che “umanizza i dati” senza perdere rigore, perché ogni raccomandazione resta collegata a metriche e fonti reali.
Metti alla prova l’embedding SEO, senza complicarti la vita
Forse pensi che l’embedding SEO sia troppo tecnico, o che non sposti il posizionamento. È una reazione normale, soprattutto se in passato hai già provato altre attività efficaci per generare traffico organico.
Ma con l’avvento dell’AI le cose stanno cambiando e serve alzare il livello dei siti web. Sì può mantenere il lavoro SEO classico e aggiungere un livello semantico leggero, che riduce cannibalizzazioni, definisce meglio i gap e migliora la pertinenza, quindi anche l’esperienza di chi atterra sul sito.
Se vuoi accelerare ma non sai da dove partire, richiedi un’analisi per impostare gli embeddings e costruire una mappa semantica.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.