
Pubblicato il
Data quality: come gestire la qualità dei dati per decisioni migliori
Web Analytics
Passiamo ore a perfezionare una dashboard o a calibrare il budget di una campagna, convinti che avere un grafico chiaro sotto gli occhi coincida con l’avere il controllo della situazione. Eppure, nel lavoro quotidiano di chi si occupa di analisi si tende a dare per scontato l’elemento più importante e cioè l’origine esatta di quei numeri. La tentazione di agire subito sulla base di una metrica rassicurante è spesso più forte della pazienza necessaria a verificarne l’affidabilità, ma senza questa verifica, qualsiasi scelta di tipo strategico poggia su fondamenta fragili.
Indice dei contenuti
Che cos’è la data quality
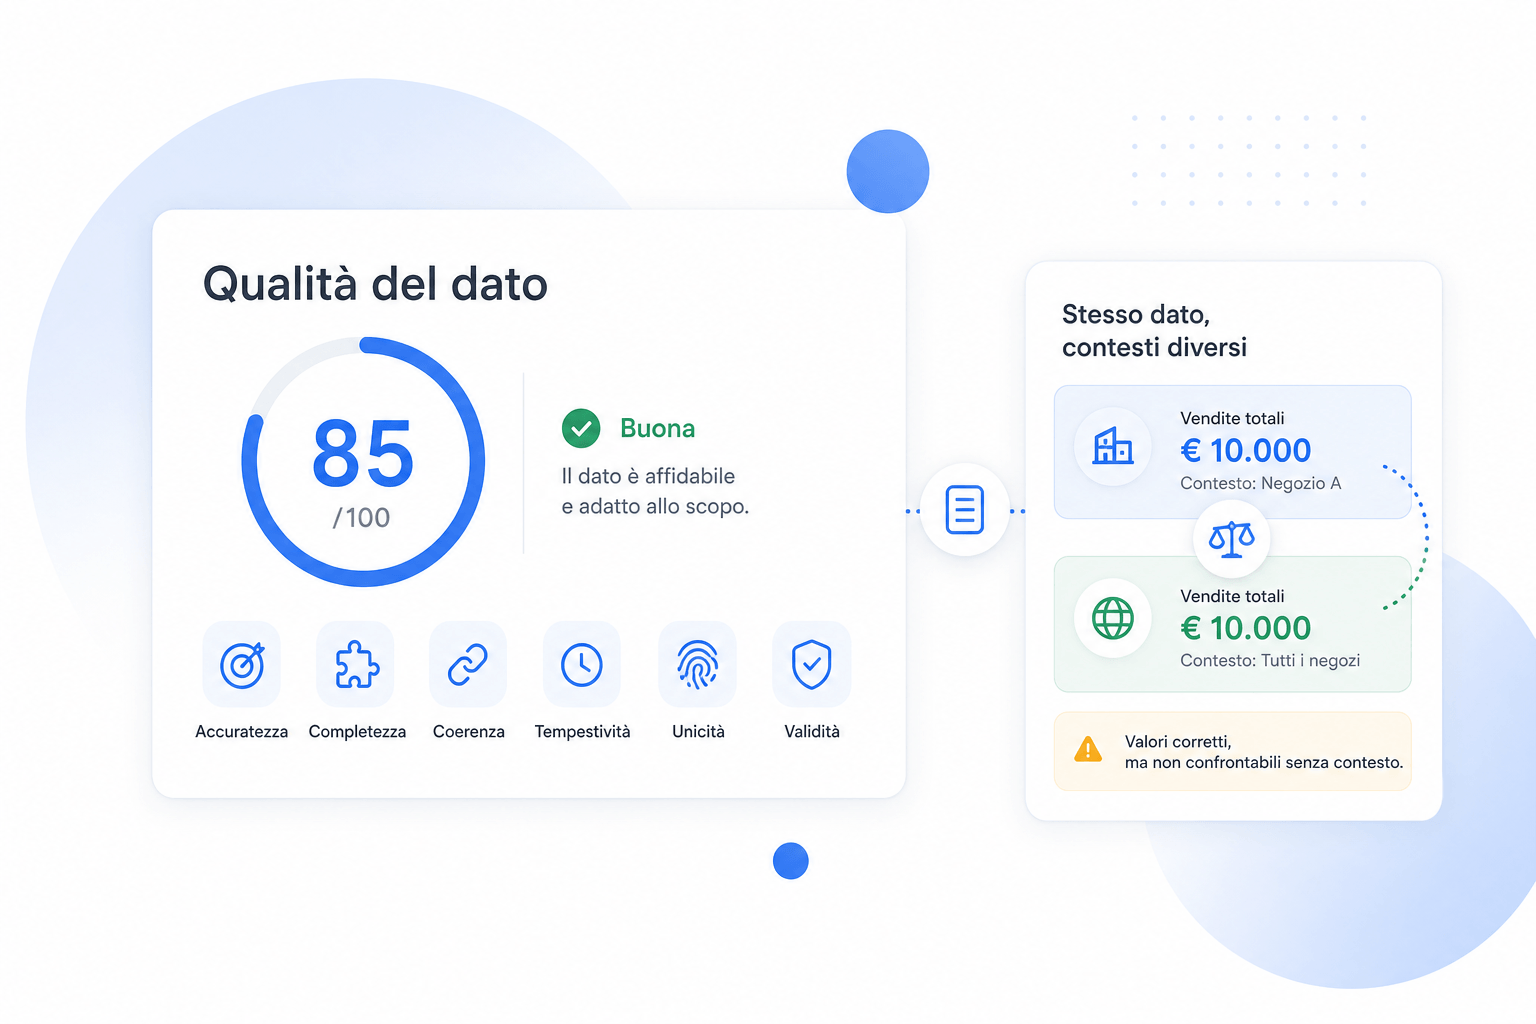
La data quality è l’insieme delle caratteristiche che rendono un dato utilizzabile per lo scopo per cui viene raccolto, come accuratezza, completezza, coerenza, tempestività, unicità e validità. Un dato può essere disponibile in un sistema e restare comunque inadatto a sostenere una decisione, se gli manca una di queste proprietà.
Un valore tecnicamente corretto, ovvero estratto senza errori dal sistema che lo genera, può rivelarsi di scarsa qualità se manca di contesto, o se viene confrontato con un dato raccolto attraverso criteri diversi da chi dovrebbe misurare la stessa cosa. Ognuna di queste dimensioni conta in modo diverso a seconda del contesto, e le riprendo una per una più avanti.
Perché è importante avere una buona data quality
Un’organizzazione che lavora su dati di scarsa qualità produce cattive analisi soprattutto, perché parte da un materiale che non regge la portata della domanda che gli viene posta, più che per un limite di competenza di chi le realizza. Vale lo stesso principio del traffico organico di un sito, dove contare le visite senza sapere se generano valore rischia di fotografare quanto il sito esiste, senza dire nulla su quanto lavora per il business.
Con la data quality il problema si presenta prima ancora: se il dato di partenza non è affidabile, tutto quello che viene elaborato a partire da lui eredita la stessa fragilità, e più passaggi quel dato attraversa, più diventa difficile risalire a dove l’errore ha avuto origine.
L’impatto sui processi aziendali e sulla governance
La qualità del dato dipende tanto da chi lo raccoglie quanto da chi lo analizza, ma soprattutto da chi decide come i diversi sistemi aziendali si scambiano quell’informazione. Governarla significa avere ruoli precisi: qualcuno responsabile di ogni fonte dati, e una regola chiara su cosa succede quando emerge un’anomalia, chi la valuta, chi interviene, in quanto tempo.
Senza questi ruoli, un problema di qualità emerge quasi sempre per caso. Un caso tipico è quando un team marketing lancia una campagna su un segmento di pubblico costruito a partire da un CRM pieno di contatti duplicati. Il problema viene a galla solo quando il tasso di conversione non torna con quello previsto, e a quel punto il budget è già speso.
La qualità è una condizione da presidiare fin dall’inizio attraverso una chiara data strategy. Questo significa anche stabilire una sorgente unica di verità (Single Source of Truth): l’azienda deve definire a monte quale sia il database o lo strumento ufficiale per ogni metrica, così da evitare che reparti diversi prendano decisioni basandosi su fonti in contraddizione tra loro. Diventa quindi fondamentale mappare l’infrastruttura di tracciamento e selezionare le piattaforme più adatte per raccogliere le metriche corrette, una valutazione che si può fare analizzando con attenzione le caratteristiche dei principali strumenti di web analytics a disposizione.
Le dimensioni della data quality
Una dimensione della qualità dei dati è un parametro specifico che serve a valutare se un’informazione è corretta e utilizzabile. Si tratta, in pratica, di un criterio di misurazione chiaro per verificare aspetti come la completezza, l’aggiornamento o l’assenza di duplicati. Dire che un dato è completo all’85% offre una misura concreta, affermare che un dato è “buono” non spiega invece rispetto a quale elemento si stia esprimendo il giudizio.
Le caratteristiche principali da considerare sono sei, ma la loro rilevanza cambia in base agli obiettivi del progetto. Per capire come cambiano le priorità, basta confrontare due attività differenti.
Nel caso di un e-commerce, la dimensione fondamentale è la tempestività, un ritardo di poche ore nel registrare le scorte di magazzino rischia di causare la vendita di prodotti esauriti. In questo scenario la velocità di aggiornamento conta quanto la precisione della cifra indicata.
Un’anagrafica B2B risponde invece a esigenze diverse, i dettagli cambiano raramente e una verifica mensile basta a garantire l’efficacia del servizio. Per questa tipologia di informazioni la dimensione chiave diventa la completezza, ovvero il numero di campi utili raccolti per ogni singola azienda.
Comprendere quale aspetto meriti la priorità assoluta è la base fondamentale per impostare la strategia di monitoraggio.
Accuratezza e completezza
L’accuratezza misura quanto un dato rispecchia la realtà che dovrebbe rappresentare, la completezza misura quanto di quella realtà è stato raccolto.
Sono due dimensioni che vengono confuse con facilità, ma un dato può essere accurato e incompleto insieme: un’anagrafica clienti con il campo email compilato correttamente nel 100% dei casi disponibili, ma con metà dei clienti che non ha mai fornito quel dato, è accurata su ciò che contiene e incompleta su ciò che manca.
Nel marketing digitale un problema di accuratezza tipico riguarda l’attribuzione del traffico: una configurazione errata di GA4 può attribuire a un canale organico visite che in realtà arrivano da una campagna a pagamento, restituendo un dato tecnicamente presente ma falso nella sostanza.
Un problema di completezza, invece, si vede spesso in un funnel di conversione dove un pixel mal installato registra solo una parte degli eventi, facendo apparire un calo di performance che in realtà è un buco nella raccolta dati.
Coerenza e tempestività
La coerenza riguarda il confronto tra fonti diverse che dovrebbero raccontare la stessa cosa con lo stesso metodo.
Un problema di questo tipo emerge quasi sempre quando quel dato viene rappresentato in un grafico o in una dashboard, più che nel dato grezzo preso da solo. Infatti è nella data visualization che un’incoerenza logica si rivela a chi la deve interpretare, anche senza competenze tecniche, perché due linee che dovrebbero muoversi insieme e invece divergono attirano l’attenzione molto prima di due colonne di numeri lette in una tabella.
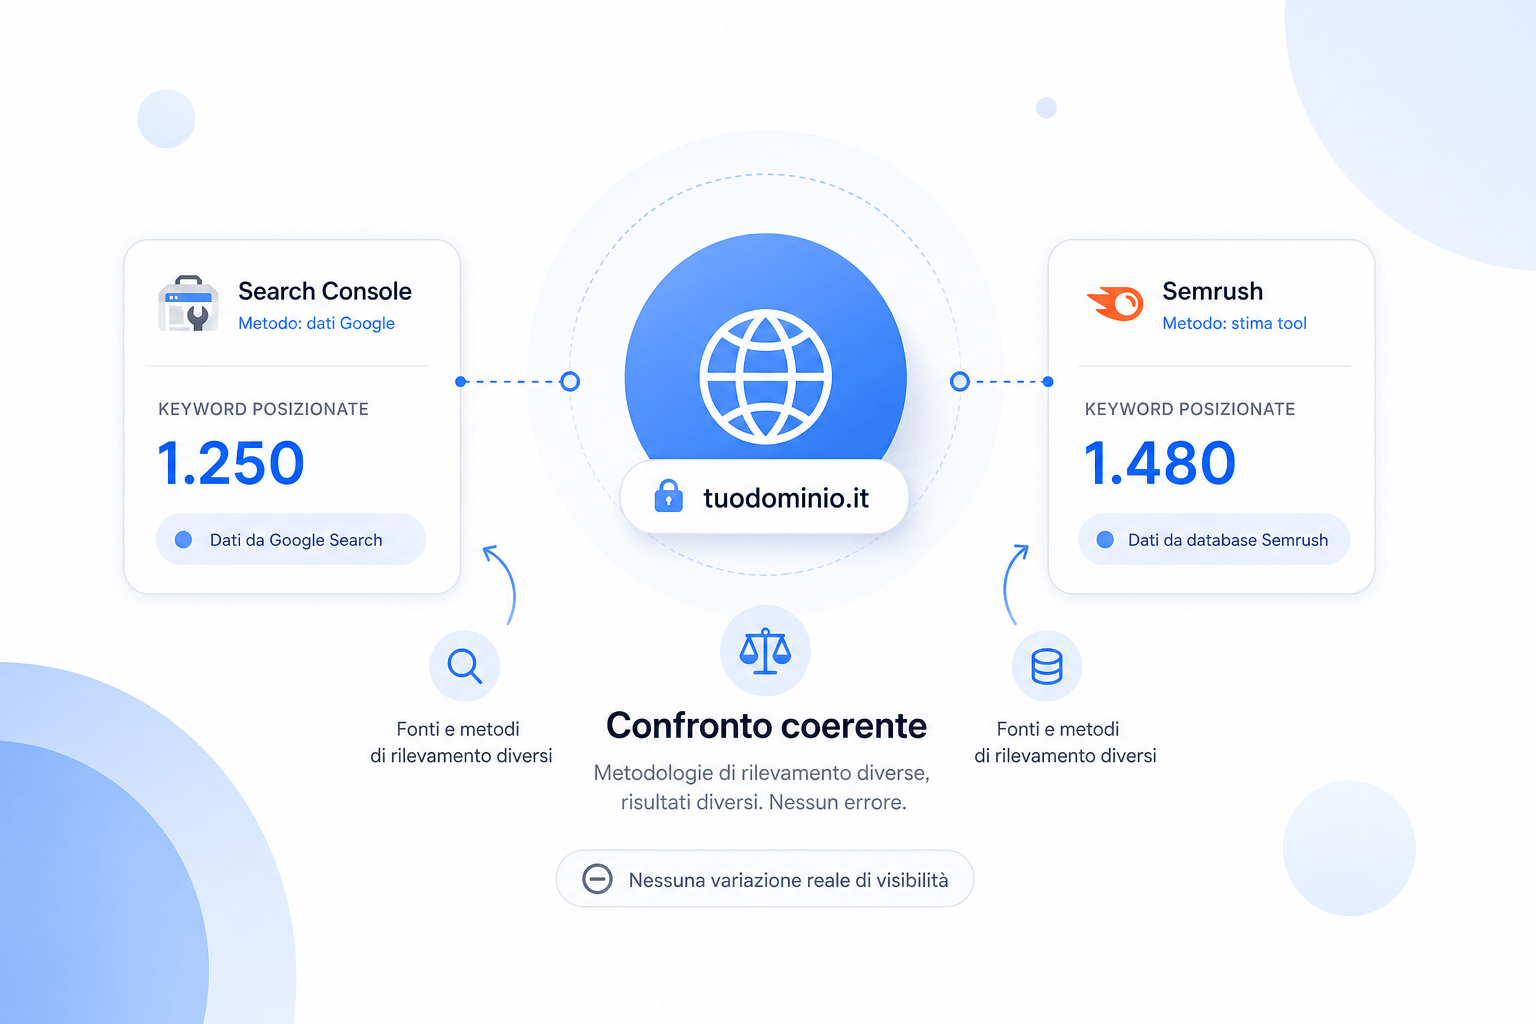
Un esempio ricorrente in ambito SEO è il numero di keyword posizionate: Search Console e un tool terzo come Semrush possono restituire valori diversi per lo stesso dominio, non perché uno dei due sbagli, ma perché usano metodologie di rilevamento differenti, e confrontarli senza saperlo porta a conclusioni sbagliate su un presunto calo o aumento di visibilità.
La tempestività misura invece quanto il dato resta valido nel tempo che intercorre tra la sua raccolta e il suo utilizzo. Un dato di posizionamento che viene aggiornato una volta a settimana può risultare superato in un mercato molto competitivo, dove le posizioni cambiano quotidianamente sotto la spinta dei concorrenti.
Affidabilità e conformità
L’affidabilità matura attraverso la verifica ripetuta che un dato continua a comportarsi come dovrebbe nel tempo. Un sistema che estrae dati correttamente per sei mesi e poi inizia a duplicare record senza che nessuno se ne accorga, mostra quanto l’affidabilità sia una proprietà del dato che va rinnovata.
La conformità riguarda il rispetto di normative e standard, dalla privacy alle regole di settore, tipo una lista di contatti raccolta senza un consenso esplicito e tracciabile può essere tecnicamente completa e accurata, ma resta un dato non conforme, con conseguenze che vanno oltre la qualità dell’analisi e toccano direttamente il rischio legale dell’azienda.
Unicità e validità
L’unicità verifica l’assenza di record duplicati o ridondanti, un problema che nasce quasi sempre da un difetto di comunicazione tra sistemi diversi: lo stesso lead compilato su due form differenti del sito, uno per la newsletter e uno per una richiesta di preventivo, può generare due contatti distinti nel CRM invece di uno solo, falsando qualunque conteggio costruito su quel dato, dal numero reale di lead generati al tasso di conversione di una campagna.
La validità verifica invece il rispetto di formati e regole richiesti per ogni campo. Un esempio pratico di questa dimensione è un parametro UTM scritto in modo incoerente da una campagna all’altra, con maiuscole e minuscole miste o spazi al posto dei trattini, spezza il tracciamento e fa apparire come traffico diretto quello che in realtà proveniva da una campagna specifica.
⚠️ Nota sulla conformità: l’affidabilità nel tempo e il rispetto delle normative sulla privacy come il GDPR sono requisiti legali e operativi imprescindibili che si ottengono solo quando queste sei dimensioni base sono presidiate con costanza.
Come valutare la qualità dei dati nella tua azienda
Valutare la qualità di un dato senza un metodo condiviso porta a giudizi soggettivi, dove ciò che sembra un problema per un reparto passa inosservato per un altro. Per questo la fase di analisi ha bisogno di una struttura ripetibile, da appliacare con la stessa regolarità con cui si controlla un bilancio.
Framework e metodologie operative
Un’analisi strutturata segue in genere tre passaggi.
- Definire le dimensioni prioritarie per quello specifico insieme di dati, invece di misurarle tutte allo stesso modo senza distinzioni.
- Misurarle con regole precise: la percentuale di record completi rispetto al totale, lo scarto tra fonti diverse sullo stesso indicatore, il tempo medio che intercorre tra la raccolta e la disponibilità del dato per chi deve usarlo.
- Confrontare il risultato nel tempo, non isolarlo in una singola rilevazione, seguendo la stessa logica di ciclo di ottimizzazione continua che regola qualunque processo di miglioramento strutturato.
Il valore di questo tipo di analisi si esprime nel confronto con le rilevazioni precedenti: una percentuale di completezza dell’85% dice poco da sola, dice molto se il mese prima era al 95%, perché quel dieci per cento perso segnala un cambiamento nei processi a monte che va indagato.
Le componenti di un framework strutturato
Un framework tiene insieme quattro componenti che funzionano bene solo se applicate insieme:
| Componente | Cosa garantisce | Cosa succede se manca |
| Regole di qualità | Criteri chiari sulle dimensioni che contano di più per quel dato | Ogni reparto giudica la qualità con criteri diversi |
| Responsabilità assegnate | Una persona precisa risponde di ogni fonte dati | Nessuno interviene finché il problema non è già visibile |
| Misurazione continua | Il controllo avviene nel tempo, non una tantum | Un errore emerge solo quando ha già prodotto danni |
| Processo di correzione | Tempi e passaggi definiti per intervenire | Il problema resta noto ma irrisolto |
Altra fonte per approfondire.
Come migliorare la qualità di un dato già raccolto
Costruire regole non basta se il dato che già possiedi contiene errori accumulati nel tempo. Migliorare la qualità di un dataset esistente richiede un intervento in più fasi:
- Data profiling: un’analisi preliminare che fotografa lo stato reale del dato, quanti valori mancano, quanti sono duplicati, quanti escono dai formati attesi, prima di decidere dove intervenire;
- Data cleansing: la correzione vera e propria attraverso la normalizzazione dei formati, la rimozione di valori palesemente errati e l’integrazione dei campi mancanti dove possibile;
- Deduplica: l’identificazione e l’unione dei record che rappresentano la stessa entità (un cliente, un lead, un prodotto) inseriti più volte con lievi differenze;
- Arricchimento: l’integrazione di dati mancanti attingendo da fonti esterne affidabili, quando il dato originale non può essere recuperato altrimenti;
- Validazione in ingresso: lo spostamento del controllo a monte, nel punto in cui il dato viene generato, invece che a valle, quando ormai è già stato usato per un’analisi o una decisione.
Quest’ultimo punto costituisce la vera svolta nel lungo periodo. Correggere un dato a posteriori richiede molte più risorse e lascia una finestra temporale scoperta in cui le informazioni imprecise possono aver già orientato le scelte aziendali. Bloccare i valori non validi all’ingresso elimina il problema alla radice.
Come l’AI cambia l’approccio ai dati
L’intelligenza artificiale non introduce un problema nuovo nella storia della data quality, ma cambia la velocità e la scala con cui un problema esistente produce conseguenze. Un errore che prima restava confinato a un report letto da poche persone oggi può alimentare un sistema che prende decisioni, genera contenuti o risponde direttamente a un cliente, senza che nessuno intervenga tra il dato sporco e il suo utilizzo.
Machine learning e predittività basata su dati puliti
Un modello predittivo impara dai pattern presenti nei dati con cui viene addestrato, senza modo di distinguere un pattern effettivo da uno generato da un errore sistematico di raccolta.
Un esempio concreto in ambito marketing riguarda la dimensione dell’unicità: se un modello stima il valore futuro di un cliente basandosi su un CRM pieno di contatti duplicati, imparerà a considerare “normale” un comportamento d’acquisto che in realtà appartiene allo stesso utente registrato più volte. Il risultato sarà una previsione del valore medio fortemente distorta verso l’alto.
Questo tipo di errore è più insidioso di un semplice errore di calcolo perché produce un risultato all’apparenza plausibile, difficile da mettere in discussione senza tornare a verificare l’integrità del database di partenza. L’algoritmo e il tuning dei parametri passano in secondo piano se la base informativa manca di unicità.
La mancanza di validità nei formati rappresenta un ostacolo altrettanto critico quando si affida all’AI l’automatizzazione di attività operative, come l’invio di flussi di email o la categorizzazione dei lead. Stringhe di testo sporche, date registrate con standard diversi o parametri UTM scritti in modo incoerente confondono i modelli di linguaggio, che finiranno per indirizzare l’azione al destinatario sbagliato o per interrompere del tutto il processo automatico.
Lo stesso principio si applica ai modelli generativi (LLM) integrati nei sistemi aziendali: un sistema di assistenza automatizzato che attinge a un database privo di coerenza o validità produrrà risposte errate o “allucinazioni” strutturate. L’AI generativa amplifica l’impatto del dato scadente, restituendo informazioni false con un tono autorevole e ingannevolmente corretto.
Automazioni, monitoraggio continuo e AI applicata alla pulizia
Il monitoraggio automatizzato della qualità del dato aiuta a intercettare un’anomalia nel momento in cui si genera, invece che molto tempo dopo.
Un sistema di questo tipo funziona impostando soglie di riferimento per ogni dimensione da monitorare, per esempio un intervallo atteso per il volume giornaliero di record in ingresso da una fonte, e generando un alert quando un valore esce da quell’intervallo. La parte più delicata di questo lavoro più che tecnica è di calibrazione: soglie troppo strette generano un numero di alert così alto da spingere chi li riceve a ignorarli, soglie troppo ampie lasciano passare inosservati problemi importanti.
In uno scenario come questo, l’AI interviene anche come alleata nel processo di data cleansing e deduplica. I modelli di Machine Learning sono in grado di riconoscere anomalie complesse e variazioni semantiche che sfuggirebbero a un controllo basato su regole rigide, identificando ad esempio record duplicati scritti in modi differenti o correggendo automaticamente i difetti di validità nei formati prima che i dati entrino nelle pipeline analitiche.
Per trovare il punto giusto è necessario conoscere il comportamento che di norma ha quel dato nel tempo, cosa che un sistema si affina osservando il flusso dei dati nel tempo.
Best practice per mantenere alta la qualità dei dati
Una volta migliorato un dataset esistente e messo in piedi un sistema di monitoraggio, resta il passaggio più difficile: mantenere quel livello di qualità nel tempo.
Cultura del dato e responsabilità condivise
La qualità del dato è il primo pilastro di una vera data culture aziendale, perché nessuno strumento si rivela efficace se chi raccoglie le informazioni non ne comprende il valore strategico.
Questa proprietà si preserva mantenendo le imperfezioni visibili a chi ha la responsabilità di correggerle, anche a costo di mostrare un numero meno rassicurante del previsto all’interno di un report, anziché nasconderle dietro medie che appiattiscono le anomalie.
Pratiche quotidiane per mantenere la qualità nel tempo
- Rivedere periodicamente le regole di qualità, perché un business che cambia rende obsoleti criteri definiti anche solo un anno prima.
- Coinvolgere chi raccoglie il dato nella lettura dei risultati, non solo chi lo analizza.
- Documentare ogni correzione applicata, per non ripetere lo stesso intervento su un errore che si ripresenta con un’altra forma.
- Trattare un calo di qualità come un segnale da indagare subito, e non come un’eccezione.
Un investimento che genera valore misurabile
Trattare la data quality come un costo da comprimere è la scelta più diffusa, ed è anche la più rischiosa. Identificare un’anomalia all’inizio del flusso richiede attenzione, ma evita errori decisionali a valle che comporterebbero costi di risoluzione ben più elevati.
Vuoi verificare lo stato dei tuoi dati?
Se lavori su un progetto dove i numeri non tornano, o dove i report raccontano ciascuno una versione diversa della stessa situazione, contattami. Capiamo dove si origina il problema, prima di ragionare su come rappresentarlo meglio.
Cosa si intende per data quality?
La data quality è l’insieme delle caratteristiche che rendono un dato realmente utilizzabile per lo scopo per cui è stato raccolto: accuratezza, completezza, coerenza, tempestività, affidabilità, conformità, unicità e validità. Un dato può essere tecnicamente corretto e comunque inadatto a sostenere una decisione, se gli manca anche solo una di queste proprietà. Non basta che il numero sia presente in un sistema: conta se racconta davvero la realtà che dovrebbe rappresentare.
Quali sono le dimensioni principali della data quality?
Le dimensioni chiave sono sei: accuratezza, completezza, coerenza, tempestività, affidabilità, conformità, a cui si aggiungono unicità e validità come criteri operativi di verifica. La loro priorità cambia in base al progetto: in un e-commerce conta soprattutto la tempestività degli aggiornamenti di magazzino, in un’anagrafica B2B pesa di più la completezza dei campi raccolti. Non esiste una gerarchia fissa, va decisa in base agli obiettivi di chi userà quel dato.
Che cos’è la Single Source of Truth e perché serve?
È la sorgente unica di verità: il database o lo strumento che un’azienda definisce come ufficiale per ogni metrica, in modo che reparti diversi non prendano decisioni basandosi su fonti in contraddizione tra loro. Senza questa scelta a monte, un problema di data quality emerge quasi sempre per caso, spesso quando il budget di una campagna è già stato speso. Fa parte a tutti gli effetti di una data strategy ben impostata.
Chi si occupa della qualità dei dati in azienda?
Applicare la data quality significa assegnare ruoli precisi: qualcuno responsabile per ogni fonte dati e una regola chiara su chi valuta un’anomalia, chi interviene e in quanto tempo. Senza questa responsabilità assegnata, un errore resta invisibile finché non ha già prodotto un danno concreto. È una funzione di data governance, solitamente eseguita da un Data Engineer o un Data Analyst.
Qual è la differenza tra accuratezza e completezza dei dati?
L’accuratezza misura quanto un dato rispecchia la realtà, la completezza misura quanto di quella realtà è stato effettivamente raccolto: sono due dimensioni distinte e spesso confuse. Un’anagrafica clienti può avere l’email corretta al 100% su chi l’ha fornita, ma restare incompleta se metà dei clienti non l’ha mai indicata. Un errore di attribuzione in GA4 è un problema di accuratezza, un pixel che registra solo parte degli eventi è un problema di completezza.
Come si migliora la qualità di dati già raccolti?
Servono più fasi in sequenza: data profiling per fotografare lo stato reale del dato, data cleansing per correggere formati ed errori, deduplica per unire record duplicati e arricchimento per integrare i campi mancanti da fonti esterne affidabili. Il passaggio più decisivo resta però la validazione in ingresso, cioè spostare il controllo nel punto in cui il dato viene generato invece che correggerlo a posteriori, quando ha già potuto orientare decisioni sbagliate.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.