
Pubblicato il
Cos’è l’analisi esplorativa dei dati e come fare l’EDA
Web Analytics
L’analisi esplorativa dei dati, in inglese Exploratory Data Analysis o EDA, è una fase preliminare dell’analisi statistica in cui si esaminano e si visualizzano i dati grezzi per comprenderne la struttura, i pattern nascosti e le anomalie prima di creare modelli formali.
Questa osservazione iniziale rientra nella data exploration, perché prima di applicare una tecnica dobbiamo capire che cosa abbiamo davanti e quali controlli servono.
Quando apro un insieme di dati non posso considerare corrette tutte le righe soltanto perché si trovano dentro un file ordinato. Potremmo trovare righe duplicate o campi rimasti vuoti, mentre un numero fuori scala può cambiare una media e portarci verso una conclusione sbagliata; anche una data registrata con un formato diverso può rendere inattendibile un confronto.
L’analisi esplorativa serve a individuare questi problemi prima che condizionino il lavoro successivo.
Ho letto online una guida di IBM dedicata all’EDA che insiste anche su un altro aspetto, e cioè sul fatto che i dati vanno esaminati senza costringerli a confermare un’idea precostituita. Possiamo partire da una supposizione, però dobbiamo lasciare aperta la possibilità che quello che troviamo ci porti da un’altra parte.
A me piace definire questo tipo di analisi sui dati come un processo investigativo, perché all’inizio abbiamo molti elementi e ancora nessuna ricostruzione affidabile.
Indice dei contenuti
Quali sono gli obiettivi dell’analisi esplorativa dei dati
Durante questa analisi cerchiamo soprattutto di capire se il dataset di cui siamo in possesso è affidabile, perché la qualità dei dati condiziona tutte le conclusioni che ricaveremo in seguito.
Il lavoro si sviluppa attorno ad alcuni obiettivi principali.
- Individuare errori e lacune: controlliamo campi vuoti, righe duplicate, categorie registrate con formati diversi e valori fuori scala rispetto al fenomeno da analizzare.
- Riconoscere i pattern: cerchiamo tendenze nel tempo, cicli stagionali o comportamenti che ritornano all’interno di specifici gruppi.
- Analizzare le relazioni: mettiamo a confronto due o più variabili per capire se si muovono insieme, tenendo a mente che una correlazione non dimostra da sola un legame di causa ed effetto.
- Formulare ipotesi: usiamo le evidenze emerse per definire quali spiegazioni approfondire con verifiche successive, test statistici o modelli.
Pensiamo a un report di Google Analytics nel quale il traffico da mobile crolla da un giorno all’altro. Quel numero ci dice che il calo c’è stato, ma non ci dice il motivo; siamo noi a dover capire che cosa sia successo prima di attribuire una causa alla variazione.
Il primo controllo riguarda il sistema di tracciamento, perché se lo strumento ha smesso di raccogliere correttamente le visite da alcuni dispositivi, tutto il resto dell’analisi partirebbe da un dato incompleto.
Se i tag di monitoraggio funzionano, confrontiamo il traffico mobile con quello desktop per capire in quale canale si concentra la variazione. Soltanto dopo aver escluso un errore tecnico o di tracciamento ha senso verificare se nello stesso periodo è terminata una campagna o se è cambiato il comportamento degli utenti.
La spiegazione arriva alla fine di questo percorso, quando abbiamo elementi sufficienti per sostenerla.
Come si svolge un’analisi esplorativa dei dati
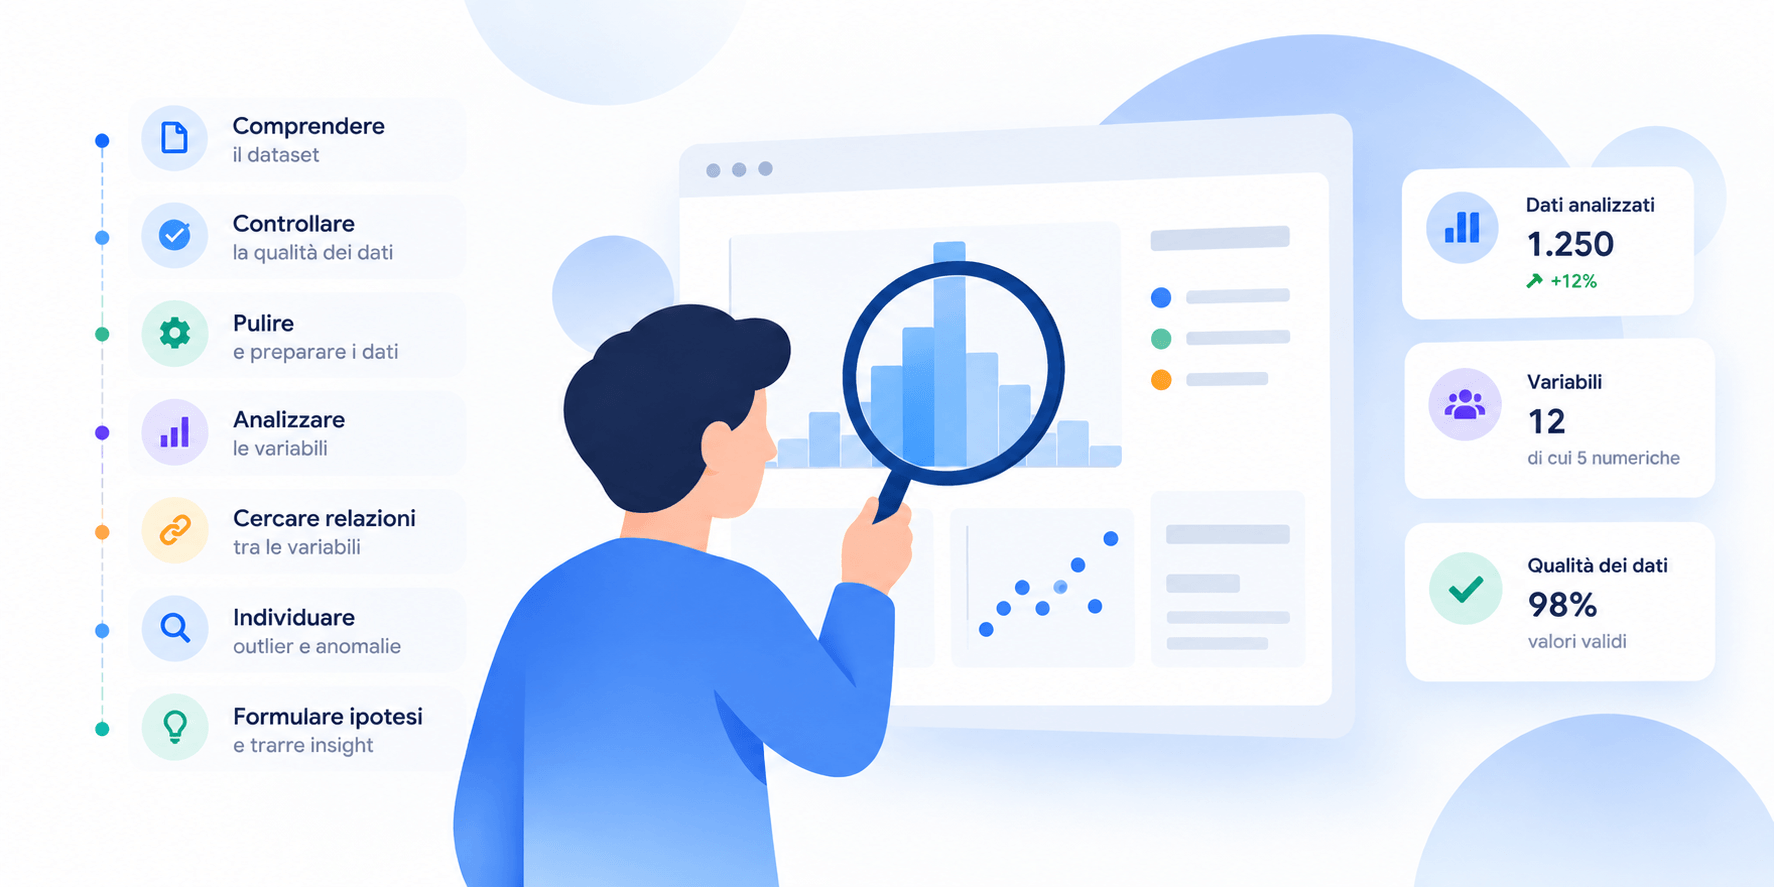
Un’analisi esplorativa non segue sempre una sequenza rigida, perché il lavoro cambia in base al dataset e alle domande a cui vogliamo rispondere. In genere, però, il percorso parte dalla comprensione dei dati, passa attraverso la loro pulizia e l’analisi delle variabili, per arrivare all’individuazione di pattern e alla formulazione di ipotesi.
Per vedere come cambia il lavoro nei diversi passaggi, prendiamo il dataset di un ecommerce che contiene gli ordini, il valore del carrello e lo sconto applicato. Possiamo aggiungere il canale di acquisizione quando ci serve capire da dove arriva il cliente.
1. Comprendere e controllare il dataset
Prima di fare calcoli o costruire grafici dobbiamo capire cosa abbiamo davanti.
Controlliamo quali variabili sono disponibili, che tipo di informazioni contengono, come sono state raccolte e se ci sono dati mancanti, duplicati o valori che non sembrano plausibili.
Nel nostro ecommerce, per esempio, potremmo verificare che ogni ordine abbia un identificativo univoco, che il valore del carrello sia numerico e che uno sconto non superi limiti compatibili con le regole commerciali.
Questa prima verifica serve a capire se il dataset può essere utilizzato così com’è oppure se richiede interventi prima di iniziare l’analisi.
2. Pulire e preparare i dati
La pulizia dei dati accompagna l’intera analisi esplorativa, perché molti problemi emergono proprio mentre osserviamo distribuzioni e relazioni.
Un valore mancante può essere sostituito, escluso o mantenuto, mentre un outlier può dipendere da un errore oppure rappresentare un comportamento reale. Nel dataset ecommerce, per esempio, un ordine da 10.000 euro potrebbe essere un errore di registrazione oppure un acquisto aziendale perfettamente valido.
La decisione dipende quindi dal contesto. Eliminare automaticamente tutti i valori estremi potrebbe cancellare eventi importanti, mentre conservarli senza verificarli potrebbe deformare statistiche e grafici.
⚠️ Per questo conviene documentare le modifiche effettuate e conservare sempre una copia dei dati originali.
3. Analizzare le variabili
Una volta verificata la qualità del dataset possiamo iniziare a esplorare le variabili. Qui entrano in gioco analisi univariata, bivariata e multivariata: non sono tre fasi consecutive, ma tre modi di osservare i dati con livelli crescenti di complessità.
Analisi univariata
L’analisi univariata prende in esame una variabile alla volta.
Nel dataset dell’ecommerce potremmo iniziare dal valore degli ordini, calcolando media, mediana, moda, quartili e deviazione standard, per poi osservare la distribuzione attraverso la data visualization, come ad esempio un istogramma o un box plot.
Una media del carrello pari a 84 euro sembra già darci un’informazione utile, però il grafico potrebbe mostrarci che la maggior parte degli ordini rimane sotto i 40 euro e che pochi acquisti molto elevati hanno spostato il valore medio.
La mediana, in quel caso, ci darebbe qualcosa di più vicino al comportamento abituale dei clienti.
Analisi bivariata
Con l’analisi bivariata osserviamo due variabili insieme e cerchiamo una possibile relazione.
Possiamo confrontare lo sconto con il valore del carrello attraverso un grafico a dispersione oppure verificare se gli ordini cambiano quando aumenta la percentuale di sconto.
Se il valore degli acquisti cresce insieme allo sconto, abbiamo trovato una correlazione da approfondire. Prima di concludere che la promozione abbia provocato l’aumento, però, dobbiamo controllare anche il periodo nel quale sono stati raccolti i dati, perché una ricorrenza o una campagna potrebbero aver contribuito allo stesso risultato.
Analisi multivariata
L’analisi multivariata mette insieme tre o più variabili e ci permette di aggiungere il contesto che manca nel confronto precedente.
Lo sconto potrebbe aumentare il valore del carrello soltanto tra i nuovi clienti arrivati dalle campagne, mentre sugli utenti abituali potrebbe produrre un effetto diverso.
Una matrice di correlazione, una heatmap o una serie di grafici affiancati ci aiutano a osservare queste combinazioni senza perdere leggibilità. Quando inseriamo troppe informazioni nello stesso grafico, infatti, il rischio è nascondere proprio le relazioni che stavamo cercando.
4. Individuare pattern, anomalie e relazioni
L’obiettivo dell’esplorazione non è soltanto descrivere le singole variabili, ma capire se nei dati compaiono comportamenti ricorrenti o situazioni che meritano attenzione.
Possiamo trovare segmenti di clienti con comportamenti simili, variazioni concentrate in particolari periodi, differenze tra canali di acquisizione oppure valori anomali che richiedono una verifica.
È in questo momento che i dati iniziano a suggerire nuove domande.
Se scopriamo, per esempio, che gli ordini provenienti da un determinato canale hanno un valore medio più alto, possiamo chiederci se la differenza dipende dal tipo di pubblico, dalla campagna utilizzata o da un diverso comportamento di acquisto.
5. Formulare ipotesi da approfondire
L’analisi esplorativa non serve necessariamente a dimostrare qualcosa. Serve soprattutto a capire quali spiegazioni vale la pena verificare.
Una relazione osservata nei dati può quindi trasformarsi in un’ipotesi da approfondire con ulteriori analisi, test statistici o modelli.
Nel nostro esempio potremmo ipotizzare che uno sconto aumenti il valore del carrello soltanto per alcuni segmenti di utenti. A quel punto dovremo raccogliere altre evidenze per capire se l’effetto esiste davvero e quali altre variabili possono averlo influenzato.
L’esplorazione termina quindi non quando abbiamo trovato una spiegazione definitiva, ma quando abbiamo abbastanza elementi per formulare domande più precise.
Quali strumenti usare per l’analisi esplorativa dei dati
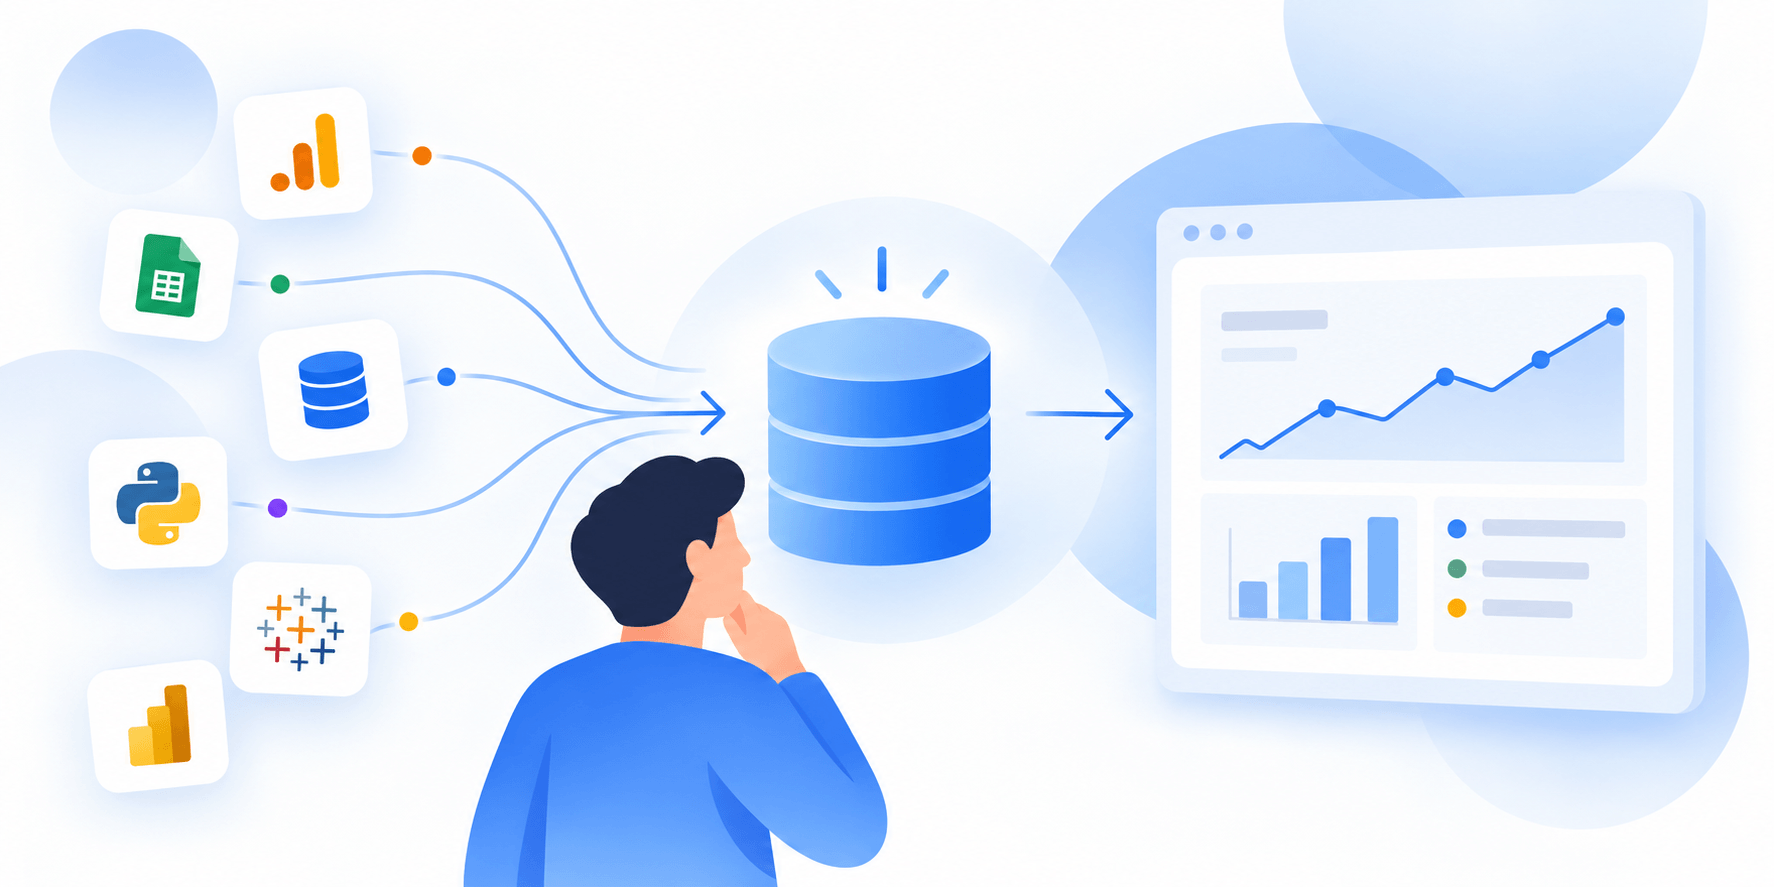
Per scegliere lo strumento guarderei prima dove si trovano i dati e quale controllo devo eseguire. Un’esportazione con poche righe può essere analizzata in Excel o Google Sheets, dove riusciamo a ordinare i valori e costruire i primi grafici senza preparare un ambiente di lavoro più complesso.
Quando i dati si trovano in un database, SQL ci permette di estrarre le informazioni che servono senza spostare tutto il contenuto in un altro ambiente. Se l’analisi deve essere ripetuta con regolarità, possiamo utilizzare Python o R per automatizzare la pulizia e applicare gli stessi controlli alle versioni aggiornate del dataset. Data Studio, Tableau e Power BI rispondono invece a un’esigenza successiva, cioè rendere il risultato consultabile anche dalle persone che non hanno svolto direttamente l’analisi.
Nel mio lavoro, però, il limite di alcuni progetti emerge ancora prima dell’analisi, perché Google Analytics può dirci quali pagine sono state visitate senza mostrarci tutti i comportamenti che ci servono per rispondere a una domanda. Per questo ho sviluppato alcuni tool proprietari con cui posso raccogliere e interrogare informazioni che gli strumenti standard non gestiscono.
Questi strumenti mi permettono di costruire un dataset intorno alle richieste specifiche di ogni singolo progetto, invece di limitarmi alle informazioni che le piattaforme hanno già deciso di registrare. Una volta raccolti e messi in relazione i dati, l’analisi esplorativa può lavorare su una base più aderente al comportamento delle persone.
Dall’analisi esplorativa dei dati ai modelli statistici e di machine learning
Fin qui abbiamo visto come l’analisi esplorativa serva a controllare un dataset e capire cosa contiene. In alcuni progetti il lavoro si ferma a un report o a una dashboard; quando l’obiettivo è anticipare un risultato, usiamo quello che abbiamo scoperto per costruire un modello statistico o di machine learning.
Quando parlo di modello mi riferisco a un sistema che stima il valore futuro degli ordini o identifica le visite a maggior rischio di abbandono. Il software individua le relazioni nei dati già raccolti e prova ad applicarle a scenari che non ha ancora visto.
L’analisi esplorativa deve precedere questa fase perché la bontà della stima dipende da come è stato costruito il punto di partenza. Dobbiamo sapere cosa contengono le variabili e come sono state registrate, altrimenti rischiamo di consegnare al modello informazioni che anticipano proprio l’evento da stimare.
Pensiamo a un algoritmo progettato per individuare chi completerà un acquisto sul sito. Se tra le variabili inseriamo la visualizzazione della pagina di conferma, il sistema riceve un dato disponibile soltanto a transazione avvenuta. In fase di test otterrà punteggi eccellenti perché sta usando un’informazione privilegiata, ma davanti a una navigazione in corso quell’elemento non ci sarà.
L’esplorazione iniziale serve proprio a scovare queste incongruenze, guidandoci a verificare cosa contiene ciascun campo e in quale momento viene salvato. Permette anche di valutare se i casi da analizzare sono sufficienti. Se soltanto una visita su cento genera un acquisto, un’accuratezza del 99% può appartenere a un modello che risponde sempre “nessuna conversione”, ignorando del tutto gli utenti che comprano davvero.
Anche dopo l’elaborazione del modello è normale tornare sui dati, specialmente se le prestazioni mostrano errori imprevisti o valori distanti dalle attese. L’esplorazione resta quindi un’attività continua, utile per verificare le ipotesi iniziali alla luce dei risultati ottenuti.
Se raccogli dati dal sito, dalle campagne o dai software di tracciamento e vuoi capire cosa accade dietro una variazione, verifichiamo insieme la qualità della raccolta con una consulenza di Web Analytics.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.