
Pubblicato il
Guardrail AI: limiti intelligenti per LLM più affidabili
AI

Chi lavora con l’intelligenza artificiale lo scopre presto: un modello può essere brillante e, nello stesso minuto, sorprendentemente disinvolto con i fatti, con la privacy o con il tono. I guardrail AI nascono per questo, come i guardrail in autostrada: non rendono la guida meno veloce, la rendono meno distruttiva quando qualcosa va storto.
Con gli LLM il tema non è soltanto evitare risposte sbagliate, è governare comportamenti, confini e responsabilità in contesti reali, dal customer care alla ricerca interna, fino ai processi regolati. E poi c’è la parte più sottile, quella che spesso manca nelle demo: i guardrail non sono un lucchetto messo dopo, sono un modo di progettare interazioni che restino utili anche nel momento in cui l’utente chiede troppo, chiede male o chiede l’impossibile.
Prima di discutere strumenti e architetture, serve mettere a fuoco cosa stiamo davvero cercando di proteggere, e da quali rischi concreti.
Indice dei contenuti
Cosa sono i guardrail AI e perché servono
I guardrail AI sono il tentativo più pragmatico di portare l’intelligenza artificiale fuori dal laboratorio senza farle combinare guai. Quando un LLM passa dalla chat di prova a un flusso aziendale, il problema non è solo se risponde bene, ma se risponde entro confini chiari: cosa può dire, cosa non deve dire, cosa deve chiedere prima, quando deve fermarsi.
Definizione di guardrail per gli LLM: controlli, policy e vincoli per modelli generativi
Un guardrail, in pratica, è un insieme di controlli e policy che incorniciano il comportamento di un modello generativo. Incorniciare significa mettere regole prima e dopo la generazione: filtrare input sospetti, impedire che certi dati entrino nel contesto, controllare l’output, imporre formati, bloccare azioni rischiose. È un lavoro meno scintillante del prompt perfetto, ma molto più vicino a ciò che serve quando l’LLM diventa una funzione di prodotto.
Dentro la parola guardrail convivono livelli diversi. C’è la parte tecnica, come la validazione di payload e la redaction dei dati sensibili. C’è la parte di processo, come logging e audit, perché ogni volta che qualcosa va storto bisogna ricostruire il percorso. E c’è la parte di linguaggio, perché la qualità non è solo correttezza: conta il tono, conta la chiarezza, conta l’aderenza a policy interne e normative.
Un buon modo per pensarli è questo: i guardrail non cercano di rendere l’LLM più intelligente, cercano di renderlo affidabile. E affidabile, nel mondo reale, significa prevedibile a sufficienza da poter essere messo in mano a utenti veri, con esigenze vere e abitudini poco gentili.
Guardrail vs prompt engineering: differenze, complementarità e limiti
Il prompt engineering lavora soprattutto sulla probabilità: spinge il modello verso una risposta desiderata con istruzioni, esempi, contesto. Funziona, spesso benissimo, finché l’utente resta nel perimetro atteso. I guardrail invece lavorano sul perimetro stesso: definiscono cosa è permesso, cosa è vietato, cosa richiede conferma, cosa va mascherato.
Le due cose si parlano, ma non si sostituiscono. Un prompt può invitare l’LLM a non divulgare dati personali, ma se nel contesto finiscono numeri di carta, token o anagrafiche, la tentazione statistica resta lì. Un guardrail interviene in modo più fisico: rimuove quelle stringhe, blocca la risposta, forza una riscrittura, o impedisce proprio che il dato entri nella finestra di contesto.
C’è anche un limite strutturale: il prompt engineering vive dentro lo stesso canale che può essere attaccato. Se un utente prova una prompt injection ben costruita, sta giocando sul campo del linguaggio. I guardrail spostano parte della difesa fuori dal linguaggio, con controlli che non dipendono dall’obbedienza del modello. È meno poetico, ma è ciò che riduce davvero il rischio in produzione.
Model guardrails e agent guardrails: riduzione del rischio in produzione per LLM e agenti
Quando si parla di model guardrails, di solito si intende tutto ciò che governa l’input e l’output del modello: moderazione dei contenuti, redaction, vincoli di formato, controlli su citazioni e fonti, verifiche di coerenza. È la cintura di sicurezza che resta valida anche se l’applicazione attorno cambia.
Gli agent guardrails entrano in scena quando l’LLM non si limita a scrivere testo, ma usa strumenti: cerca in un database, apre ticket, invia email, modifica record, avvia pagamenti. Qui il rischio cambia natura. Non è più soltanto dire qualcosa di sbagliato, è fare qualcosa di sbagliato. Serve una logica di permessi, di conferme esplicite, di sandbox, e una tracciabilità che assomiglia più alla sicurezza applicativa che alla linguistica.
In produzione la distinzione è utile perché aiuta a progettare controlli diversi per problemi diversi. Un chatbot informativo può vivere con guardrail principalmente testuali. Un agente con tool calling richiede guardrail orientati alle azioni: limiti per operazione, rate limit, approvazioni umane, e una definizione rigorosa di cosa significhi successo o fallimento, perfino nell’occasione in cui il modello prova a rispondere senza accuratezza e conoscenza del contesto.
Tipi di guardrail AI: statici e dinamici, in input e in output
Per orientarsi tra i guardrail conviene usare una tassonomia semplice, fatta di due assi: come funzionano e quando intervengono. Il primo asse (verticale) distingue i controlli statici, basati su regole fisse, da quelli dinamici, che si adattano al contenuto e al rischio. Il secondo asse (orizzontale) separa le protezioni in input, prima che il modello generi, da quelle in output, dopo la generazione.
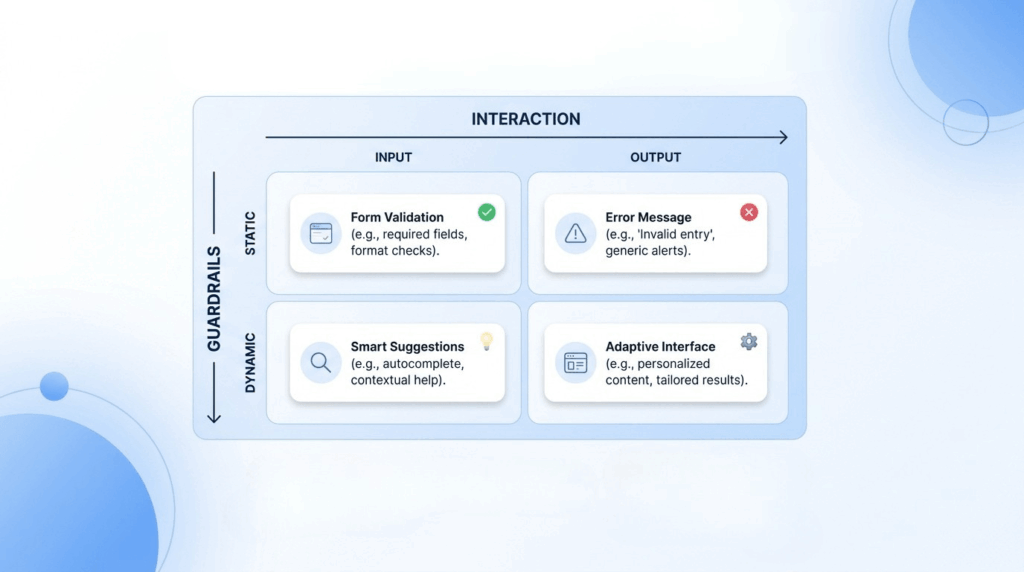
È una distinzione pratica, perché ti dice subito dove mettere il parapetto e quanta “intelligenza” e autonomia dargli. In molti sistemi reali i due assi si combinano, perché una sola barriera raramente basta.
Approfondiamo ora singolarmente ognuno di essi.
Guardrail statici: regole e vincoli deterministici
I guardrail statici sono i più “terra terra” e, proprio per questo, spesso i più utili. Li costruisci con regole deterministiche che non lasciano spazio a interpretazioni: se una condizione è vera, scatta un blocco, una correzione o una richiesta di chiarimento. Qui dentro trovi policy scritte in modo esplicito, controlli su parole e pattern, vincoli di formato e validazioni. Funzionano come un tornello: passa chi ha il biglietto giusto, gli altri si fermano. Nessuna magia, solo scelte chiare.
Nella pratica si traducono in controlli molto concreti, spesso già familiari a chi lavora con sicurezza e compliance. Per esempio, una regex può intercettare un codice fiscale o un numero di carta e impedire che finisca in output, mentre una allowlist limita le azioni disponibili a un set preciso di comandi o strumenti. Anche l’imposizione di formati obbligatori rientra qui: output in JSON valido, campi sempre presenti, lunghezze massime, niente testo libero dove servono valori strutturati.
E poi ci sono le liste di blocco, utili per termini sensibili, prompt injection ricorrenti o contenuti non ammessi, con la consapevolezza che vanno curate nel tempo. Un set tipico include:
- policy e regole di business (cosa si può dire, cosa va rifiutato, quando chiedere consenso)
- blocklist/allowlist per parole chiave, intenti, strumenti e domini consentiti
- validazione di formati obbligatori (JSON, tabelle, campi, range numerici) e controlli via regex
Danno il meglio quando il perimetro è chiaro e misurabile. Customer care con risposte brevi e standard, workflow che richiedono campi precisi, sistemi regolati dove certe informazioni non devono mai uscire, sono casi in cui la prevedibilità vale più della creatività. Anche la protezione dei dati personali è un terreno naturale: mascheramento, rimozione, stop a pattern riconoscibili. Se sai già cosa è vietato e come deve apparire una risposta “accettabile”, i guardrail statici rendono l’esperienza più stabile. E aiutano anche a fare audit, perché puoi spiegare esattamente quale regola ha bloccato cosa.
Il rovescio della medaglia è la rigidità. Le regex si rompono con un accento, una spaziatura strana o un formato internazionale, e le liste diventano subito una collezione infinita di eccezioni. C’è poi la manutenzione: nuove policy, nuovi prodotti, nuove minacce, nuovi modi di aggirare i controlli, tutto richiede aggiornamenti frequenti e test. Se esageri con i blocchi, aumentano i falsi positivi e l’utente si sente respinto senza motivo, come un filtro antispam troppo nervoso. Per questo di solito funzionano bene come primo strato, chiaro e verificabile, ma raramente bastano da soli quando il linguaggio diventa sfumato e il contesto conta davvero.
Guardrail dinamici: controlli adattivi e basati sul contesto
I guardrail migliori non sono cartelli fissi, sono semafori che cambiano colore. Un assistente interno che risponde a un manager e a un consulente esterno non può usare gli stessi limiti, anche se la domanda è identica. Qui entrano i guardrail dinamici: regole che si adattano a utente, ruolo, livello di autorizzazione, canale e momento. Se l’utente è autenticato e sta lavorando su un ticket reale, il modello può essere più operativo, se arriva da una chat pubblica, diventa più prudente. È un modo concreto per tenere alta l’utilità senza aprire varchi inutili.
Questa adattività nasce da segnali che puoi misurare, non da intuizioni. Un classificatore può riconoscere richieste legate a dati personali, a istruzioni per attività pericolose o a tentativi di jailbreak, e assegnare un risk scoring che guida la risposta. Anche il retrieval può essere “a rubinetto”: se la richiesta tocca documenti HR o contratti, il sistema recupera solo fonti consentite per quel ruolo, o restituisce estratti ridotti e tracciabili.
Lo stesso vale per i tool: il tool gating decide se l’LLM può avviare un rimborso, inviare una mail o eseguire una query, e lo fa solo quando identità, permessi e contesto sono coerenti. In pratica, il modello diventa bravo a dire: posso aiutarti, ma entro confini che cambiano con te.
Quando il rischio sale, serve una scala di escalation chiara, perché un blocco secco è spesso un boomerang. Se il punteggio è medio, l’assistente può rallentare e chiedere conferma, magari imponendo un passaggio in più prima di mostrare dettagli sensibili. Se il punteggio è alto, può ridurre la granularità, offrire linee guida generali e togliere di mezzo esempi operativi che potrebbero essere riutilizzati male. Se l’utente insiste o la richiesta è ambigua, la cosa più onesta è passare la palla a un umano, senza far perdere tempo. Funziona bene quando la sequenza è esplicita:
- Conferma e chiarimenti: domande brevi, verifica dell’intento, richiesta di autorizzazione.
- Risposta attenuata: meno dettagli, più sicurezza, citazione di policy e fonti consentite.
- Handoff: inoltro a operatore, compliance o IT, con log e contesto già pronti.
Un dettaglio che spesso fa la differenza è la coerenza: i guardrail dinamici devono cambiare comportamento senza sembrare capricciosi. Per questo conviene registrare decisioni e motivazioni, così da poter auditare perché un tool è stato bloccato o perché una fonte non è stata recuperata, e correggere rapidamente falsi positivi. Serve anche un ciclo di test continuo, con casi realistici e tentativi di abuso, perché le scorciatoie degli utenti cambiano più in fretta delle policy.
Se progetti bene questi controlli, l’esperienza resta fluida, e la sicurezza smette di essere un muro diventando un sistema di corsie. E ogniqualvolta arriva l’eccezione, che arriva sempre, hai già previsto come gestirla senza improvvisare.
Guardrail in input: prevenire prompt injection, dati sensibili e richieste non consentite
L’input è la prima porta di casa, e spesso è anche la più trascurata. Prima ancora di far ragionare l’LLM, conviene ripulire e rendere stabile ciò che riceve, con una buona sanitizzazione e una normalizzazione del prompt. Vuol dire tagliare caratteri di controllo, spazi invisibili, sequenze ambigue, link mascherati e trucchi con omografi che cambiano il senso di un testo senza farsi notare. Serve anche mettere limiti chiari a lunghezza e struttura, perché un prompt infinito o pieno di allegati “creativi” è un invito a perdere il controllo del contesto. Se il modello parte da una base pulita, metà dei problemi smette di nascere.
Il passo successivo è riconoscere la circostanza in cui l’utente sta provando a guidare l’assistente fuori strada. La prompt injection e i tentativi di jailbreak hanno segnali ricorrenti: richieste di ignorare regole, di rivelare istruzioni interne, di trasformare un compito innocuo in uno vietato, di “fare finta” di essere un altro sistema. Qui funzionano approcci combinati, senza farsi ipnotizzare da una sola tecnica: regole lessicali, classificatori, controlli di intent, e soprattutto una gerarchia di istruzioni che non si lascia riscrivere dal testo dell’utente. Quando un input supera una soglia di rischio, non si “discute” con il prompt, si devia il flusso: si chiede chiarimento, si riduce l’azione, si blocca con motivazione breve e coerente.
La privacy, poi, va trattata come materiale fragile, non come un dettaglio. Prima che l’input finisca nel prompt finale, conviene fare redazione PII e minimizzazione: se non serve un dato, non deve viaggiare. In pratica si può:
- mascherare o rimuovere email, numeri di telefono, codici fiscali, IBAN, indirizzi e identificativi cliente
- sostituire i dati con placeholder coerenti, utili al ragionamento ma non riconducibili a una persona
- applicare regole diverse per canali diversi, perché una chat pubblica non è un ticket interno
Questi filtri vanno pensati anche per i “quasi dati”, come note operative, screenshot trascritti o copie di documenti, che spesso contengono più informazioni del necessario.
Quando usi RAG o carichi documenti, il guardrail in input deve fare il buttafuori anche lì. Prima si controlla cosa può entrare nel contesto: meno testo, più rilevanza, e niente pagine intere solo perché “ci stanno” nella finestra. Poi si mettono paletti su quali fonti sono ammesse, con allowlist, permessi per ruolo e controlli di provenienza, così un file sbagliato non diventa la nuova verità del modello. Va anche bloccata l’esecuzione di istruzioni trovate nei documenti, perché un paragrafo in un PDF non deve avere lo stesso potere di una policy di sistema.
Il risultato è una conversazione più sobria e più affidabile, in cui l’LLM riceve solo ciò che serve davvero e non ciò che capita.
Guardrail in output: validare risposte, formato e sicurezza prima di mostrarle
L’ultimo tratto è quello dove si fanno più danni, perché l’utente vede solo la risposta finale. I guardrail in output lavorano qui: prendono il testo generato e lo passano in una serie di controlli che verificano sicurezza e conformità alle regole di prodotto. La content moderation intercetta linguaggio d’odio, istruzioni per attività illegali, autolesionismo, contenuti sessuali non ammessi o dettagli pericolosi, e decide se tagliare, bloccare o trasformare. Non è censura, è gestione del rischio, soprattutto quando il modello è inserito in un servizio pubblico o in un flusso aziendale. Se un tema è consentito ma sensibile, l’output può restare, con un registro più prudente e un invito a rivolgersi a canali appropriati.
Subito dopo arriva la parte più delicata: capire se la risposta sta in piedi. Qui entrano fact-checking e grounding, cioè il controllo che ciò che il modello dice sia ancorato a fonti affidabili o a documenti interni. In molte applicazioni le citazioni non sono un optional: se un’affermazione non può essere supportata da una fonte, va riformulata come ipotesi, o tolta. Funziona bene anche una regola semplice e spietata: niente numeri, date o prescrizioni operative senza riferimento verificabile. Se le fonti sono ambigue o in conflitto, la risposta migliore spesso è ammettere l’incertezza e chiedere un dettaglio in più, invece di rispondere con testi poco accurati.
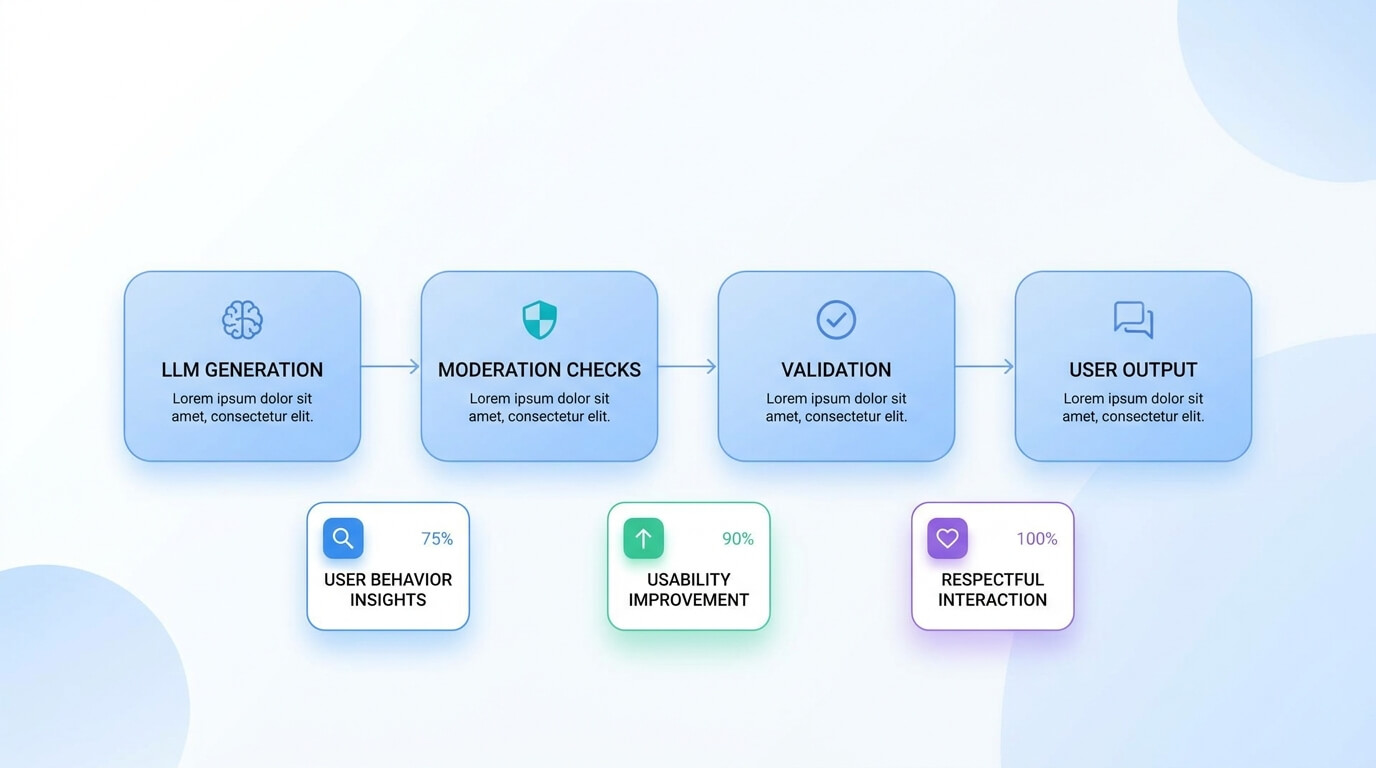
Quando l’output deve finire in un sistema, non basta che sia corretto, deve anche essere nel formato giusto. La validazione schema (per esempio su JSON) controlla campi obbligatori, tipi, enum, lunghezze, e impedisce che una virgola fuori posto rompa un’integrazione o, peggio, apra falle. In parallelo si fa pulizia: rimozione o mascheramento di PII come email, numeri di telefono, indirizzi, codici fiscali, e qualunque dato personale che non abbia un motivo esplicito per comparire. Spesso questi controlli funzionano meglio come una catena breve e chiara:
- Moderazione del contenuto e blocco delle categorie vietate
- Grounding con citazioni obbligatorie e segnalazione dell’incertezza
- Validazione di JSON o del formato richiesto, con correzione automatica quando possibile
- Redazione PII e controllo di tono, con disclaimer dove serve
Alla fine serve una decisione, non un report. Se un check fallisce, il sistema deve sapere cosa fare: bloccare l’output, riscriverlo in modo sicuro, restituire una risposta parziale, o chiedere chiarimenti con una domanda secca. Il controllo del tono evita scivolate che in chat sembrano piccole, ma in assistenza clienti o HR diventano un problema, e aggiunge disclaimer quando la risposta tocca salute, finanza, legale o sicurezza.
Un buon guardrail non si limita a dire no, prova a gestire l’interazione, mantenendo utilità e limiti nello stesso momento. Se il caso è davvero borderline, la scelta più matura è instradare verso revisione umana, lasciando tracce chiare per audit e miglioramenti successivi.
Come combinare le tipologie: una strategia a livelli (defense in depth)
I guardrail funzionano meglio quando li pensi come una serie di porte, non come un unico lucchetto. Le tipologie si sommano e si coprono a vicenda, perché gli errori degli LLM raramente arrivano da un solo punto. Un filtro di input riduce il caos in ingresso, ma non può prevedere tutte le derive in uscita. Un controllo di output migliora il risultato finale, ma se nel contesto sono entrati dati sbagliati o sensibili, è già tardi. La logica della defense in depth serve proprio a questo: accettare che qualcosa passerà, e prepararsi a intercettarlo al livello successivo.
Una combinazione pratica, spesso efficace, è incrociare statico e dinamico su entrambi i lati della generazione. Sul fronte statico, tieni un set di regole chiare e stabili: categorie vietate, PII da mascherare, formati obbligatori, strumenti che non possono essere chiamati. Sul fronte dinamico, aggiungi controlli che leggono la richiesta e la risposta in tempo reale: rilevano intento, classificano il rischio e decidono se chiedere chiarimenti, ridurre la risposta o fermarsi. In mezzo ci sta il cuore del sistema, cioè il contesto: qui conviene essere parsimoniosi, perché ogni informazione in più aumenta la superficie di attacco e anche la probabilità di confusione. Il risultato è un set di guardrail che non irrigidisce tutto, ma alza la guardia quando serve.
Se vuoi trasformare questa idea in un mini-flusso operativo, puoi usare una pipeline semplice e ripetibile. Non è una ricetta unica, ma ti aiuta a evitare buchi grossi e a capire dove mettere lo sforzo.
- Pre-ingest: pulizia e validazione input (lunghezza, allegati, PII, prompt injection sospette).
- Policy statiche: regole di contenuto, tono e formati, più limiti su strumenti e azioni consentite.
- Controlli dinamici: classificazione del rischio della richiesta, scelta del template di risposta, eventuale richiesta di dettagli.
- Post-check: validazione output (sicurezza, dati sensibili, coerenza con policy, citazioni e fonti se richieste).
- Fallback: risposta ridotta, blocco, oppure collaborazione umana quando la confidenza è bassa o l’impatto è alto.
La scelta dei livelli dipende dal rischio, non dall’eleganza dell’architettura.
⚠️ Se gestisci dati sensibili, lavori in ambiti regolati o il modello può compiere azioni (invio email, ticket, pagamenti, query su sistemi), alza la soglia: più filtri a monte, più controlli in uscita, più logging e tracciabilità. Se invece stai facendo ideazione o supporto interno a basso impatto, puoi tenere un set leggero di regole statiche e un controllo dinamico orientato a privacy e tono, senza appesantire l’esperienza.
Un buon criterio è chiederti cosa succede se l’LLM sbaglia: se il danno è reversibile, puoi essere più permissivo, se il danno lascia tracce o coinvolge clienti, serve un livello di protezione in più. Quando hai dubbi, evita di sperare che il modello capisca da solo e crea nuove regole.
Tipologie di rischi che i guardrail mitigano
Quando si discute di guardrail AI, il rischio non è un concetto astratto. È una lista di incidenti già visti: risposte che incitano a comportamenti pericolosi, segreti aziendali che scivolano fuori, procedure inventate, agenti che eseguono l’azione sbagliata con grande sicurezza. Mettere ordine tra questi rischi aiuta a scegliere controlli proporzionati, senza trasformare l’LLM in un oggetto muto.
In precedenza abbiamo già visto rischi legati a:
- abusi e sicurezza: jailbreak, prompt injection e contenuti dannosi;
- Privacy e dati sensibili: PII, segreti, leakage e data exfiltration.
Ora ci concentriamo su un altro aspetto altrettanto importante: l’affidabilità della risposta.
Affidabilità: allucinazioni, bias, incoerenze e risposte non verificabili
L’allucinazione è il rischio più subdolo perché spesso non si presenta come errore, si presenta come stile. Un LLM può inventare una fonte, una procedura, un numero, e farlo con una prosa così pulita da risultare credibile. I guardrail qui devono cambiare il criterio di qualità: non basta che il testo suoni bene, deve essere verificabile.
Il tema dei bias è simile: non parliamo solo di discriminazioni esplicite, ma di suggerimenti sbilanciati, assunzioni su genere o provenienza, stereotipi infilati in frasi standard. I guardrail possono intervenire con classificatori e rubriche di valutazione, ma anche imponendo vincoli di stile e contenuto, ad esempio richiedendo spiegazioni neutrali, oppure suggerendo alternative nell’istante in cui il modello cade in semplificazioni.
Poi ci sono incoerenze e risposte non verificabili: l’LLM promette un’azione che non può compiere, confonde versioni di policy, contraddice quanto detto due messaggi prima. Un guardrail può imporre formati strutturati, richiedere citazioni o riferimenti a una knowledge base, o obbligare il modello a dichiarare l’incertezza quando non ha abbastanza contesto. Se l’LLM deve essere usato in contesti seri, anche l’umiltà diventa un requisito tecnico.
Chiariti i rischi, il passo successivo è vedere come questi controlli si combinano in un sistema: dove mettere i filtri, come far parlare policy e runtime, e come evitare che i guardrail restino un collage di regole scollegate.
Prima di andare in produzione: metti i guardrail al posto giusto
Se gli LLM devono diventare parte di un servizio reale dobbiamo sapere di aver messo tutte le dovute attenzioni. I guardrail servono proprio a questo: definire confini chiari su ciò che può entrare nel contesto, ciò che può uscire come risposta, quando l’AI deve chiedere conferma o fermarsi, e come rendere tutto tracciabile quando serve capire cosa è successo, sopratutto se qualcosa va storto.
In questo modo trasformi un comportamento probabilistico in qualcosa di strutturato da reggere sia navigazioni reali che fake, tutelare dati sensibili e guidare gli utenti in processi regolati. Perché la fiducia nell’AI nasce e cresce nel momento in cui c’è la capacità di ripeterla bene, entro regole sensate, anche quando la richiesta è ambigua, aggressiva o semplicemente fuori strada.
Cosa sono i guardrail statici?
I guardrail statici assomigliano a un cartello con un limite chiaro: liste di parole proibite, regex per intercettare numeri di carte, regole di formato, vincoli su campi obbligatori. Funzionano bene quando il rischio è noto e ripetibile, e quando vuoi comportamenti prevedibili anche sotto stress.
Cosa sono i guardrail dinamici?
I guardrail dinamici, invece, ragionano sul contesto: classificatori per la sicurezza, rilevatori di prompt injection, soglie che cambiano in base a utente, canale o dominio, fino a controlli che usano un secondo modello per valutare il primo. Sono più flessibili, ma chiedono dati, monitoraggio e un minimo di manutenzione, altrimenti “imparano” male o diventano troppo permissivi.
Come lavorano i guardrail in input?
I guardrail in input lavorano sul materiale grezzo: la richiesta dell’utente, i dati che stai per inserire nel prompt, i documenti recuperati con RAG. Qui l’obiettivo è impedire che entrino nel contesto istruzioni malevole, dati sensibili o ambiguità che portano il modello fuori strada. Un filtro statico può mascherare PII o bloccare certe intenzioni; un controllo dinamico può riconoscere una richiesta di esfiltrazione, una manipolazione del sistema prompt o un tentativo di jailbreak mascherato da domanda innocua. Questo è anche il punto giusto per fare “igiene”: normalizzare testo, ridurre ridondanze, applicare un budget di contesto e decidere quali fonti sono ammesse. Se sbagli qui, spesso l’output diventa un sintomo, non la causa.
Come lavorano i guardrail in output?
I guardrail in output entrano in scena quando il modello ha già parlato, e quindi possono validare, correggere o fermare ciò che sta per uscire. In versione statica possono imporre un JSON schema, vietare certe informazioni, applicare un template di risposta o richiedere la presenza di citazioni. In versione dinamica possono stimare tossicità, rischio legale, probabilità di allucinazione, coerenza con una knowledge base, e decidere se riscrivere, chiedere chiarimenti o passare la palla a un umano. Qui conta anche la gestione delle azioni: se il modello può chiamare API, un guardrail in output deve verificare parametri, permessi e impatto prima dell’esecuzione. Il risultato migliore arriva quasi sempre da una difesa a strati: pulizia e controllo in input, verifica e validazione in output, più log e metriche per capire dove il guardrail sta davvero salvando la situazione, e dove sta solo nascondendo polvere sotto il tappeto.
Cos’è un guardrail AI e a cosa serve?
Un guardrail AI è un insieme di regole, controlli e sistemi di sicurezza progettati per guidare il comportamento dei modelli di intelligenza artificiale e garantirne un utilizzo affidabile. Serve a prevenire output errati, dannosi o non conformi, migliorando la qualità delle risposte e riducendo rischi legati a bias, allucinazioni e uso improprio dei dati. I guardrail AI sono fondamentali per assicurare sicurezza, coerenza e compliance normativa nelle applicazioni basate su AI.
I guardrail normativi AI cosa includono?
I guardrail normativi AI includono tutte le misure necessarie per garantire che i sistemi di intelligenza artificiale rispettino leggi e regolamenti, come GDPR e AI Act. Comprendono la protezione dei dati personali, la trasparenza degli algoritmi, la mitigazione dei bias, il monitoraggio degli output e la tracciabilità delle decisioni. Questi controlli aiutano le aziende a ridurre i rischi legali e a implementare soluzioni AI etiche, sicure e conformi.
Che modelli scegliere per implementare un guardrail?
Per implementare un guardrail AI efficace, è possibile utilizzare diversi modelli in base alle esigenze: modelli di classificazione per identificare contenuti sensibili o non conformi, sistemi di moderazione per filtrare input e output, LLM ottimizzati con policy di sicurezza e modelli di verifica per controllare la qualità delle risposte. Spesso la soluzione migliore è un approccio multi-layer che combina più tecnologie, garantendo maggiore controllo, precisione e sicurezza lungo tutto il flusso AI.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.