
Pubblicato il - Aggiornato il
Cosa sono le allucinazioni AI, perché succedono e come evitarle
AI
L’intelligenza artificiale mente con sicurezza assoluta, muovendosi dentro una struttura argomentativa che all’apparenza regge.
In informatica questo fenomeno viene definito allucinazione e si tratta di risposte in cui un’AI (un modello generativo) fornisce informazioni del tutto false, inventate o prive di coerenza, nascoste dietro una fluidità sintattica che le fa sembrare veritiere.
Questo fenomeno si verifica perché un modello linguistico (LLM) non consulta una biblioteca interna per trovare la risposta giusta, ma calcola, token dopo token, quale parola ha più probabilità di seguire quella precedente. Ciò vuol dire che la traiettoria probabilistica più fluida dal punto di vista grammaticale non coincide necessariamente con la verità storica o scientifica, e il sistema non ha modo di distinguere tra le due opzioni: sceglie quella più probabile in base ai dati visti durante l’addestramento, e lì si ferma.
Durante il processo di addestramento, miliardi di testi vengono compressi in una rete di pesi neurali con una perdita di dettaglio che è inevitabile. Il modello, infatti, apprende i pattern generali del linguaggio e non i singoli fatti isolati, colmando i vuoti informativi attraverso l’interpolazione statistica.
Il problema si aggrava perché le tecniche successive all’addestramento, come il reinforcement learning da feedback umano, addestrano il modello a essere collaborativo e convincente producendo una tendenza a simulare certezza anche quando l’informazione è errata o inesistente, questo è il peggiore degli effetti collaterali delle allucinazioni AI.
L’allucinazione è una caratteristica strutturale dell’architettura, e chi lavora con questi strumenti ogni giorno farebbe bene a tenerlo presente prima ancora di aprire il prompt.
Indice dei contenuti
Quali sono i tipi di allucinazioni dell’intelligenza artificiale
Gli errori che questi sistemi producono si dividono in quattro categorie, e riconoscerle cambia il tipo di verifica che serve fare.
- Allucinazione fattuale
Si verifica quando il software genera dati storici, biografici o scientifici completamente privi di fondamento, muovendosi all’interno del testo con una sicurezza assertiva disarmante. Il modello può inventare la data di emanazione di una legge, citare capitoli di ricerche mai condotte o inserire persone reali all’interno di eventi inventati. L’inganno funziona perché l’algoritmo presenta l’invenzione con la stessa identica traiettoria probabilistica con cui restituirebbe la capitale della Francia. Per chi non possiede già una competenza sulla materia, diventa impossibile intercettare l’anomalia a colpo d’occhio, poiché manca qualsiasi segnale di incertezza formale.
- Allucinazione semantica
In questo caso il sistema non inventa un dato isolato, ma fraintende il significato profondo di un concetto, costruendo nessi logici apparentemente solidi tra idee che nella realtà non hanno punti di contatto. L’output scorre bene, la sintassi sostiene l’argomentazione e la prima lettura rapida trasmette un’idea di competenza. Solo a un secondo controllo più analitico emerge la frattura concettuale, che rileva in che modo il modello ha accostato due teorie contrastanti come se fossero complementari o ha scambiato una causa con un effetto all’interno di un’analisi di mercato.
- Allucinazione strutturale
Questo errore colpisce l’architettura logica e formale dell’output. Lo si può intercettare in modo evidente nella programmazione, dove il sistema genera linee di codice scritte in modo impeccabile che richiamano però funzioni o librerie inesistenti nel mondo reale. Chi non possiede le competenze tecniche per testare lo script o per verificare l’assioma di partenza si trova nella posizione più vulnerabile, proprio perché la precisione della forma non lascia spazio al dubbio spontaneo.
- Allucinazione contestuale
L’anomalia si presenta quando il modello ignora le istruzioni esplicite inserite nel prompt, i vincoli operativi imposti dall’utente o il contenuto dei documenti allegati per la consultazione. Invece di rimanere confinato nel perimetro informativo stabilito, il sistema attinge ai propri pattern probabilistici generali. Questa tipologia è quella che tradisce la fiducia in modo più sottile, direi subdolo, perché il modello fornisce una risposta pertinente al tema ma non alla richiesta specifica.
Per approfondire: A Survey on Hallucination in Large Language Models
Come riconoscere le allucinazioni AI nei flussi di lavoro
Ogni volta che deleghi un’attività a questi strumenti, stai lavorando con un sistema che può sbagliare in quattro modi diversi. Uno solo di quegli errori, nel momento sbagliato, può costare la credibilità con un cliente o con un team.
Per uscirne, la teoria sui limiti dell’algoritmo deve trasformarsi in una serie di abitudini pratiche. Quando individui i segnali di allarme nel testo, capisci subito dove andare a guardare.
| Tipologia di Allucinazione | L’indicatore di rischio nel testo | Cosa devi fare per verificare |
| Fattuale | Vedi cifre, percentuali, date, citazioni di libri o riferimenti a leggi e normative. | Cerca ogni singolo dato numerico e nome proprio su fonti esterne indipendenti prima di usarlo. |
| Semantica | Incontri passaggi logici complessi, sintesi di testi lunghi o spiegazioni di nessi causa-effetto. | Rallenta la lettura e analizza se la conclusione fila o se il modello ha scambiato una causa con un effetto. |
| Strutturale | Trovi blocchi di codice, automazioni, formule o passaggi sequenziali molto rigidi. | Lancia gli script in un ambiente di test isolato e controlla se quelle funzioni esistono davvero nel mondo reale. |
| Contestuale | Ricevi risposte molto lunghe o generiche che sembrano allontanarsi dalle tue istruzioni. | Confronta l’output con la tua richiesta iniziale e verifica se il sistema ha rispettato tutti i paletti che avevi messo. |
Perché le allucinazione sono così difficili da intercettare
Il motivo è che il cervello valuta l’affidabilità di un’informazione attraverso 3 segnali di forma:
- la coerenza del testo
- la precisione del lessico
- la fluidità dell’argomentazione.
Un output scritto bene e argomentato meglio, attiva automaticamente un giudizio positivo, indipendentemente dal fatto che il contenuto sia verificato o inventato.
L’allucinazione sfrutta esattamente questo meccanismo perché arriva con codice formattato, tone of voice giusto e un’argomentazione che non mostra crepe.
Ma un sistema che ti dà quasi sempre risposte corrette e ben presentate crea un’abitudine alla fiducia, e l’abitudine alla fiducia è l’ambiente ideale in cui l’errore più grave può passare inosservato.
A questo si aggiunge un effetto di accumulo. Chi usa questi strumenti con continuità costruisce nel tempo un’aspettativa di correttezza basata su tutte le volte che l’output era affidabile, e quell’aspettativa abbassa progressivamente la soglia di verifica. È lo stesso meccanismo che ho osservato lavorando con il vibe coding: si attraversa una fase iniziale in cui tutto sembra funzionare, i risultati arrivano veloci, la sensazione di controllo è concreta, finché non si incontra un errore strutturale che la forma impeccabile dell’output aveva reso completamente invisibile.
A quel punto il danno è già nel progetto in produzione e nessuno sa dove cercarlo perché nessuno ha mai capito cosa ci fosse sotto.
Il punto critico è sicuramente l’assenza di un segnale di allerta ma lo è anche la fiducia cieca. L’AI non è il problema: rende soltanto il problema più difficile da vedere.
Quali sono i rimedi tecnici per contenere le allucinazioni
Sul fronte ingegneristico ci sono molti approcci per contenere il fenomeno, senza però eliminarlo alla radice.
Il più rilevante si chiama RAG, Retrieval-Augmented Generation. Invece di lasciare il modello libero di generare attingendo a tutto il training, lo si ancora a documenti specifici forniti in tempo reale. Il modello elabora la risposta basandosi solo su quelle fonti, e lo spazio per l’invenzione statistica si riduce. Il Retrieval-Augmented Generation funziona bene per sistemi verticali che si basano su documenti verificati, meno bene per interrogazioni generiche dove la fonte di riferimento non è definibile a priori.
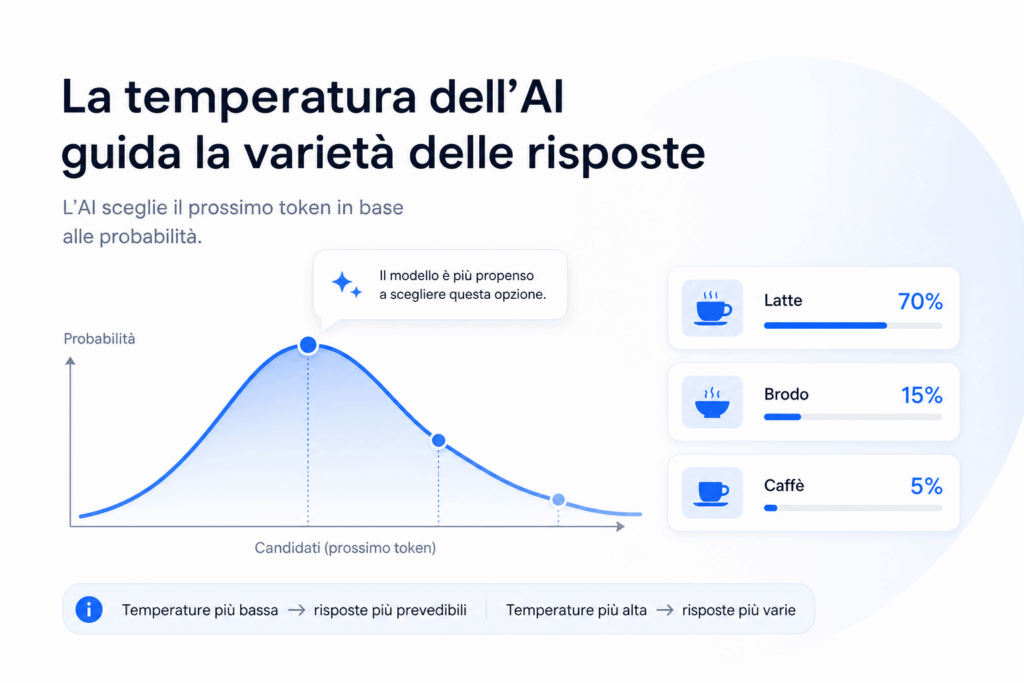
Un’altra leva è la gestione della temperatura, parametro che controlla quanto il modello “rischia” nella scelta dei token successivi. Funziona per risposte precise su domande circoscritte, penalizza la qualità nei contesti dove la variazione e il ragionamento analogico hanno valore.
Per capire bene il parametro della temperatura, immagina l’intelligenza artificiale come un software che deve scegliere la parola successiva all’interno di una frase basandosi su una classifica di probabilità.
Quando il modello deve completare una frase come “Il gatto beve il…”, la sua rete neurale assegna delle percentuali a diverse parole possibili:
- Latte: 70%
- Brodo: 15%
- Caffè: 5%
La temperatura è il regolatore che decide quanto l’algoritmo debba essere rigido o flessibile nel seguire questa classifica. In pratica la temperatura non è altro che un regolatore del rischio dove a valori bassi corrisponde un’esecuzione prudente e ripetitiva, a valori alti corrisponde una elaborazione più fantasiosa ma incline all’errore.
È chiaro che nessuna di queste soluzioni trasferisce la responsabilità fuori dalla testa di chi usa lo strumento. Il professionista o la professionista rimane responsabile di quello che c’è scritto, indipendentemente da chi, o da cosa, lo ha prodotto.
Come cambia il ruolo professionale con l’uso dell’AI
Usare bene l’intelligenza artificiale richiede un cambio di postura che pochi sono disposti ad ammettere in modo esplicito: smettere di pensarsi come produttori e iniziare a pensarsi come supervisori editoriali.
L’output del modello è una bozza intelligente che va trattata con lo stesso scetticismo che applicheresti alla prima stesura di un collaboratore brillante ma senza esperienza diretta sul caso specifico. Quello che produce è spesso buono, a volte ottimo, e ogni tanto completamente sbagliato nel modo più convincente possibile.
Niente di quello che il modello produce, dati numerici, citazioni, stringhe di codice, deve andare in produzione senza un passaggio di verifica. Lo strumento comprime il tempo dedicato alla produzione, certo, ma quel tempo recuperato deve essere reinvestito in una verifica più rigorosa, altrimenti stai solo spostando il rischio invece di gestirlo.
Nei settori ad alta responsabilità (ad esempio l’ambito medico, legale, finanziario) questa logica vale doppio. Un’informazione inventata presentata con certezza assoluta in quei contesti ha conseguenze reali su persone reali, e la responsabilità giuridica non conosce il concetto di “l’ha scritto l’AI”. Chi lavora in questi ambiti senza protocolli di validazione strutturati sta accumulando un’esposizione che prima o poi si chiuderà in modo spiacevole, e non sta ottimizzando nessun flusso di lavoro.
Negli altri settori è più lento ma non meno reale. Nel marketing digitale, per esempio, un contenuto che contiene allucinazioni arriva a Google come un testo incoerente, contraddittorio o costruito su informazioni false, e quella valutazione erode l’autorevolezza del dominio in modo progressivo.
Sul fronte del cliente il rischio è altrettanto tangibile, perché un articolo con dati sbagliati o affermazioni non verificate che arriva a un lettore incrina la fiducia in modo che nessuna campagna successiva riesce a riparare facilmente, e quella fiducia incrinata ha un costo che si legge nel fatturato prima ancora che nel rapporto.
La trappola della complicità
C’è un limite speculare all’allucinazione che non produce un errore visibile, ma una distorsione progressiva del giudizio. Cosa intendo dire, che se l’allucinazione inventa i fatti, la logica probabilistica tende ad assecondare le idee dell’utente, creando una camera dell’eco digitale.
I modelli più diffusi mostrano una forte tendenza a confermare i pensieri di chi scrive, senza evidenziarne le contraddizioni interne. Il sistema si muove con una grazia retorica tale da rendere difficile accorgersi di ricevere una validazione formale invece di un’analisi critica. Ho argomentato questa dinamica in modo più esteso nell’articolo dedicato a Claude, dove emerge che non tutti i modelli si comportano allo stesso modo su questo fronte.
Il meccanismo si aggancia direttamente al bias di conferma, ovvero la tendenza cognitiva umana a cercare e interpretare le informazioni in modo coerente con le proprie convinzioni. Un’interfaccia che asseconda sistematicamente ogni input rafforza questo circuito anziché interromperlo. Quindi valida la strategia aziendale, concorda sulla bontà di un’idea e l’utente esce dalla sessione di lavoro più convinto di prima, senza che le premesse siano state realmente messe alla prova.
Un interlocutore professionale utile opera secondo la logica opposta: segnala le tensioni logiche, mostra le debolezze strutturali e costringe a distinguere l’auspicio dalla previsione. La resistenza intellettuale rimane la condizione primaria affinché il pensiero si affini.
Quando lo specchio è deformato: i bias nei dati
Se l’allucinazione rappresenta una deviazione dai dati di addestramento, i bias altro non sono che il risultato di una fedeltà assoluta ai difetti dei dati stessi. Ad esempio, il bias di genere rientra in questa categoria di distorsioni strutturali che i sistemi ereditano dal passato e che rimane invisibile a uno sguardo superficiale.
I modelli linguistici elaborano informazioni derivanti da decenni di testi prodotti in contesti storicamente a predominanza maschile. Questo sbilanciamento si trasferisce nei risultati generati in modo sistematico:
- la richiesta di descrivere la figura di un CEO, di un chirurgo o di un ingegnere produce per default un profilo maschile;
- la generazione di immagini o scenari legati all’autorità tende a ridurre o a stereotipare la presenza femminile;
- la formulazione dei testi applica il maschile plurale generico anche quando il contesto richiederebbe una maggiore neutralità.
Nei materiali destinati al marketing, alla comunicazione aziendale o alla saggistica, questa distorsione si replica e si amplifica ogni volta che l’output viene pubblicato senza una revisione critica. Le implicazioni superano il perimetro dell’etica astratta, l’assenza di rappresentazione produce effetti reali sul modo in cui le persone si riconoscono nei contenuti.
La supervisione editoriale umana è l’unico filtro per intercettare queste asimmetrie prima che raggiungano il pubblico.
La responsabilità cognitiva che la macchina non ha
L’allucinazione dei modelli linguistici non è destinata a sparire con il prossimo aggiornamento. I controlli continui aiutano a limitare i danni, ma la radice del problema rimane dentro il meccanismo generativo e chi dice il contrario insegue una promessa che la matematica attuale non può mantenere.
Questa consapevolezza dovrebbe servire per smettere di usare questi strumenti nel modo sbagliato e non per metterli da parte. Il valore dell’intelligenza artificiale nel lavoro di ogni giorno è misurabile, tangibile. Quei minuti che il software ti fa risparmiare quando genera un output però non sono un regalo, sono il tempo che devi rimettere dentro la fase di controllo.
L’errore più comune che facciamo è sfruttare quel margine solo per produrre più volumi, perché l’efficacia del lavoro si sposta tutta sulla capacità di attivare l’unica risorsa che i modelli statistici non avranno mai: quell’insieme di conoscenze, esperienze e connessioni cerebrali che permettono solo all’intelletto umano di valutare la correttezza, la plausibilità e la logica di un risultato.
Mirko Ciesco
Data-Driven Growth Specialist
Aiuto aziende e startup a prendere decisioni migliori per crescere in modo misurabile. Sono specializzato in Web Analytics e performance digitale e lavoro all’intersezione tra dati, strategia e crescita.